▧ 원문 §III–V, Figure 2·3과 대조한 편집 해설 · 독립 재현은 별도 · 상세 연구 노트 포함 · 원논문 Figure 문맥별 해설
핵심을 먼저 읽기
π0.5의 핵심은 로봇 행동만 더 많이 모으는 것이 아니라, 서로 다른 로봇·웹·언어·소과제 데이터가 하나의 VLA에서 보완적으로 작동하도록 학습하고, 의미적 소과제와 연속 제어를 두 단계로 예측하는 것이다. (원문 §I, §IV)
이 글의 독해 목표: π0.5를 “데이터를 많이 섞은 VLA”라고 외우는 대신, ① 왜 고수준 소과제가 필요한지, ② 왜 FAST 이산 토큰과 연속 flow matching을 다른 학습 단계에 배치했는지, ③ 어떤 비교 실험이 각 주장에 근거를 주는지 이해하는 것이다. 아래 수치와 설계는 원문 §III–V 및 Figure 2·3을 대조했다. 실환경 전체의 성공률이나 공개되지 않은 하이퍼파라미터는 추정하지 않는다.
연구가 풀려는 문제
새로운 주방에서 “설거지를 정리해”라는 명령을 수행하려면 로봇은 컵을 집는 운동 기술뿐 아니라 어떤 물건을 어디에 둘지, 어떤 일을 먼저 해야 할지도 판단해야 한다. 기존 VLA는 제한된 환경에서 성공해도 배경·물체·작업 순서가 바뀌면 일반화가 어렵다. 연구자는 직접 수집한 이동형 조작 로봇 데이터만 무한히 늘리는 대신, 다른 로봇과 웹에서 학습한 정보를 전이할 수 있는지를 묻는다. 여기서 open-world란 임의의 모든 환경에 대한 성공 보증이 아니라 훈련하지 않은 실제 집에서의 조작 일반화 실험을 뜻한다. (원문 §I–II)
핵심 아이디어
이 모델은 “지금 해야 할 소과제는 무엇인가?”와 “그 소과제를 실제 관절·그리퍼 동작으로 어떻게 실행할 것인가?”라는 서로 다른 시간 척도의 질문을 하나의 모델에서 처리한다. 고수준 출력은 “접시 집기” 같은 언어 소과제이고, 저수준 출력은 일정 시간 동안 실행할 연속 행동 묶음(action chunk)이다. 같은 transformer를 쓰되 행동 부분에는 별도 action expert 가중치를 사용한다. 데이터도 단일 로봇 시연뿐 아니라 다른 로봇의 조작, 물체 위치 예측, 웹 이미지·문답 등 다양한 감독 신호를 섞는다. (원문 §III–IV)
기존 연구와 무엇이 다른가?
π0는 연속 action generation과 flow matching을 강조하는 기반 VLA인 반면, π0.5는 여기서 다양한 비로봇/타 로봇 데이터와 고수준 소과제 감독을 추가한다. 공정 비교를 위해 논문은 π0와, FAST+Flow를 결합했지만 HL/WD가 없는 π0-FAST+Flow도 사용했다. §V-D는 이 비교에서 π0.5의 우위를 보고한다. 다만 이 차이는 데이터 혼합과 학습 전략의 결합 효과이므로 “웹 데이터만 추가하면 개선”이라는 인과 주장으로 줄일 수 없다.
방법론 · 아키텍처
먼저 웹 데이터로 사전학습된 VLM에서 시작한다. 1단계 pre-training에서는 모바일 조작(MM), 다양한 집의 고정형 로봇(ME), 실험실의 여러 형태 로봇(CE), 고수준 소과제(HL), 웹 멀티모달(WD)을 섞고, FAST로 압축한 행동을 텍스트처럼 이산 토큰 예측으로 학습한다(280k gradient steps). 2단계 post-training에서는 모바일 조작과 관계가 높은 데이터를 중심으로, 사람이 선택한 verbal instruction(VI) 사례를 추가하고 연속 행동의 flow-matching action expert를 학습한다(추가 80k steps; 논문의 손실 균형 계수 α=10). 추론은 먼저 고수준 소과제를 자기회귀적으로 출력한 뒤, 이를 조건으로 10회 denoising을 통해 연속 행동 chunk를 산출한다. Figure 3이 두 학습 단계의 입력과 출력을 한눈에 정리한다. (원문 §IV-A–D)
모델 구조와 처리 흐름
개념적 처리 순서를 정리한 편집 다이어그램이며 원논문의 그림을 복제한 것은 아닙니다.
- 01
01. 입력: 장면 + 언어 목표 + 로봇 상태
로봇은 전방·손목 등의 카메라 영상, 관절·그리퍼·모바일 베이스의 상태, “주방을 정리해” 같은 자연어 목표를 입력으로 받는다. 관측은 시간에 따라 계속 갱신되며, 소과제 선택에 필요한 정보와 순간적인 행동 생성에 필요한 정보의 시간 척도가 다르다.
입력 oₜ = 카메라 영상·자기수용 상태; 목표 ℓ - 02
02. 이종 데이터로 사전학습
MM(이동형 로봇), ME(여러 집의 고정형 팔), CE(실험실의 다양한 로봇), HL(언어 소과제 라벨), WD(웹 이미지·질문·물체 위치) 데이터를 함께 제공한다. 행동 시퀀스는 FAST로 이산 토큰화해 next-token prediction으로 학습한다. 데이터의 “성격”이 달라도 통일된 토큰 예측 목표에 실을 수 있다는 점이 핵심이다.
280k steps; FAST action tokens; 범용 의미·동작 표현 - 03
03. 목표 플랫폼에 맞춘 후속학습
이동형 조작에서 실제로 중요한 MM·ME와 일부 HL·WD를 유지하고, 사람이 언어로 소과제 순서를 안내한 VI를 추가한다. 여기서 연속 행동을 생성하는 action expert를 별도로 붙여 flow matching을 함께 최적화한다. CE를 후속학습에서 제외하는 등 사전학습과 혼합 비율 자체가 달라진다.
추가 80k steps; α=10; 연속 action chunks - 04
04. 실행 중 먼저 의미적 소과제를 선택
현재 영상과 전체 목표에서 “접시를 집는다”, “싱크대로 가져간다” 같은 중간 목표를 텍스트 토큰으로 예측한다. 중요한 점은 LLM 하나와 로봇 정책 하나를 따로 연결한 시스템이 아니라, 같은 VLA 아키텍처가 두 출력을 모두 만든다는 것이다.
P(소과제 | 장면, 상위 목표) - 05
05. 선택된 소과제로 행동 chunk 생성
저수준 action expert는 소과제 조건과 현재 관측을 입력으로 받아 연속 행동 묶음을 생성한다. 논문은 10번의 flow-matching denoising 단계를 사용한다고 기술한다. 이 행동들은 50Hz 목표 명령을 추종하는 컨트롤러에 전달되지만, 50Hz가 모델 전체 추론 주파수와 같다는 뜻은 아니다.
P(연속 행동 | 장면, 소과제) → 로봇 제어 - 06
06. 관측 갱신과 소과제 전환
물체를 내려놓거나 환경이 달라지면 새로운 관측에서 다음 소과제를 선택할 수 있다. 긴 과제를 한 번에 관절 궤적으로 만드는 것이 아니라 의미적 계획과 짧은 행동 생성을 반복한다. 다만 실패 회복의 일반적 보장은 논문이 입증한 범위 밖이다.
닫힌 루프: 관측 → 소과제 → 행동 → 새 관측
Figure 3: 로봇·웹·소과제 공동학습이 연속 행동 생성으로 이어지는 구조
먼저 왼쪽의 pre-training에서 MM·ME·CE·HL·WD 데이터를 모두 FAST 이산 행동 토큰과 언어 예측으로 묶는 것을 확인한다. 다음 오른쪽 post-training에서 목표 로봇에 맞춘 데이터와 verbal instruction을 사용하며 action expert로 연속 행동을 만들도록 학습하는 변화를 본다. 이것이 이 논문의 핵심 기술 기여다. (원문 §IV, Figure 3)
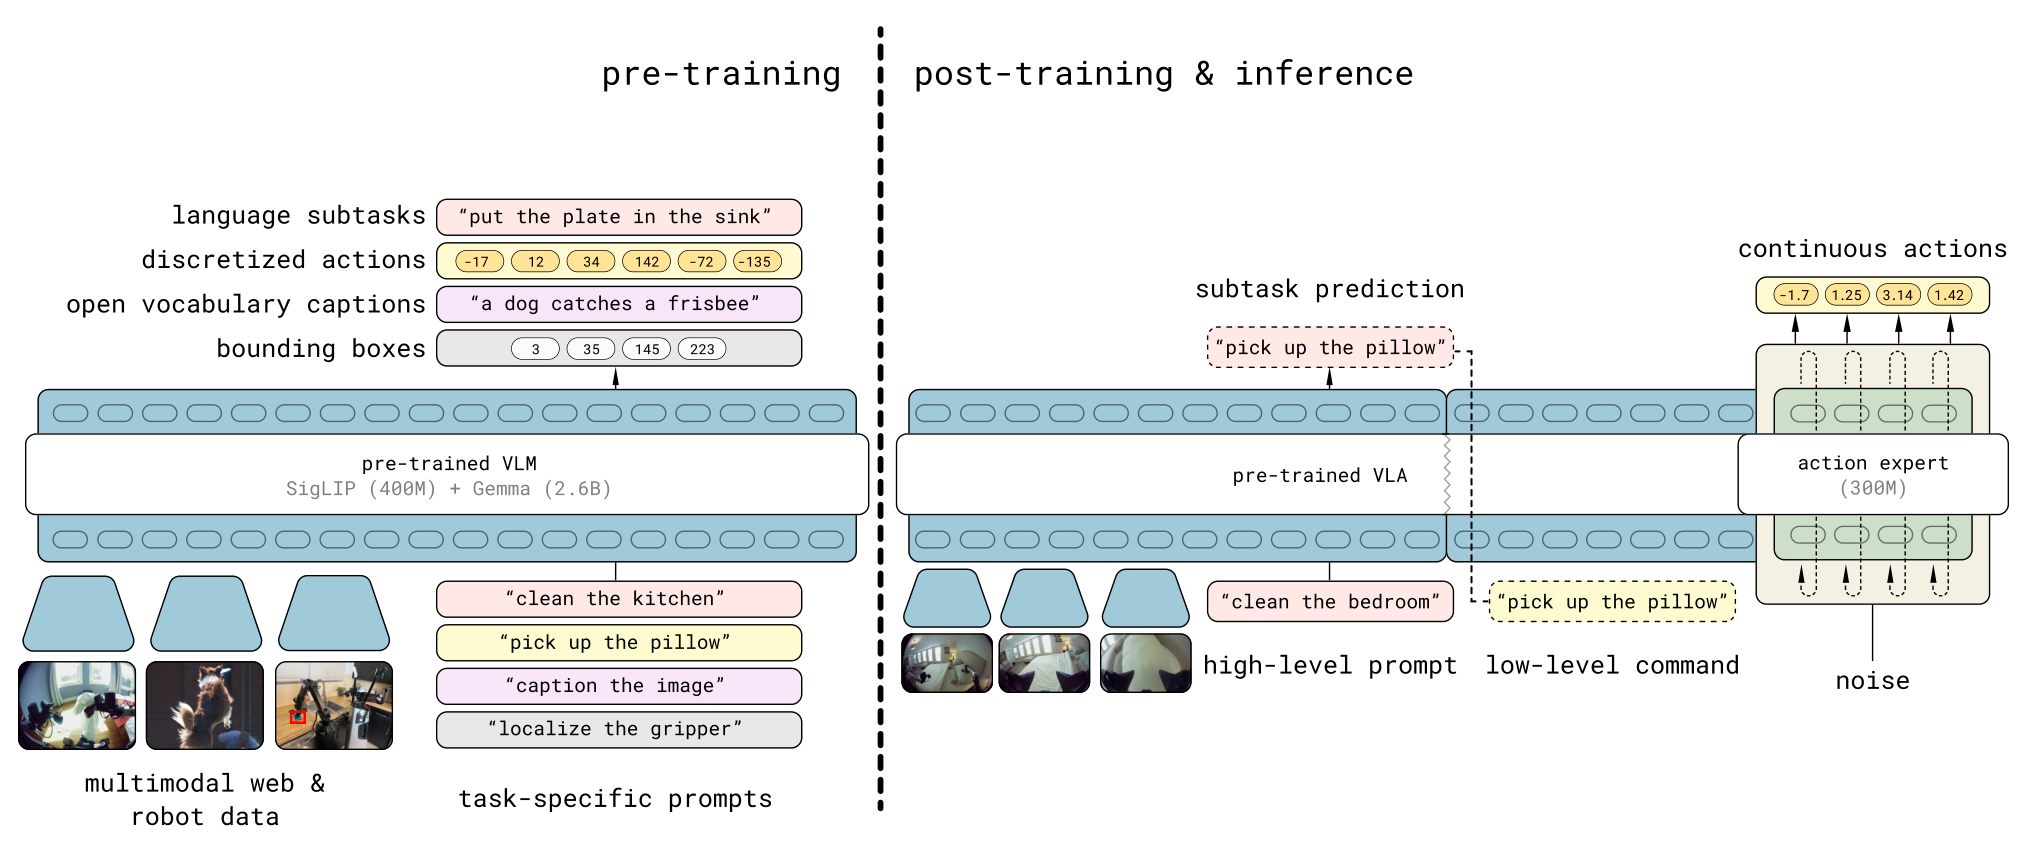
원문 캡션 일부 Fig. 3 : Model overview. π 0.5 \pi_{0.5} is trained in two stages. First, a pre-training stage combines all of the different…
- 01
① 초기 VLM: 인터넷 이미지·언어 사전학습으로 확보한 표현을 로봇 데이터에 맞게 적응시킨다.
- 02
② Pre-training 데이터: MM(모바일), ME(여러 집의 고정형), CE(실험실 크로스-임바디먼트), HL(고수준 작업 라벨), WD(웹)가 다른 감독 신호를 제공한다.
- 03
③ 이산 FAST 액션 토큰: 액션을 토큰 예측 문제로 만들어 대규모 사전학습 효율을 높인다.
- 04
④ Post-training: 목표 집안 조작을 중심으로 혼합 데이터를 조정하고 사람이 언어로 지시한 VI를 포함한다.
- 05
⑤ 연속 action expert: flow-matching으로 action chunk를 만들고, 온라인 추론 시 고수준 소과제 다음에 행동을 생성한다.
한국어 해설은 이해를 돕기 위한 편집 해석이며 저자 논문에서 검증된 수치나 그림의 모든 패널을 대체하지 않습니다.
핵심 설계·학습 신호 해설
같은 모델이 고수준/저수준을 처리한다는 의미
원문 §IV-A는 공동 분포를 P(a, ŝ | o, ℓ) = P(a | o, ŝ) × P(ŝ | o, ℓ)로 나눠 설명한다. ŝ는 모델이 고른 소과제이며, ℓ은 사용자의 큰 목표다. 저수준 행동 분포는 ŝ를 조건으로 삼기 때문에, 소과제가 틀리면 아무리 정밀한 제어를 해도 목표 자체가 엇나갈 수 있다. 이 식은 논문의 모델링 가정이지, 모든 환경에서 완벽한 계획을 뜻하지 않는다.
왜 FAST 이산 행동과 Flow Matching을 둘 다 쓰나
로봇 행동을 긴 연속 수치 벡터 그대로 토큰처럼 생성하면 계산량이 크고, 이산 FAST 토큰은 대규모 데이터 학습에 유리하다. 반대로 실시간에 필요한 정밀 연속 제어는 action expert와 flow matching이 더 적합하다. 그래서 사전학습에서는 이산 액션 토큰으로 폭넓게 학습하고, 후속학습에서 연속 액션 생성을 추가해 서로 다른 장점을 활용한다. 논문은 두 유형의 행동 표현이 서로 직접 주목하지 않도록 attention을 조정했다고 설명한다.
이종 데이터가 “더 많은 로봇 데이터”와 다른 이유
WD는 로봇 행동 라벨이 없더라도 물체 인식·언어 표현에 도움을 줄 수 있다. ME/CE는 목표 로봇과 몸체가 달라도 집기·옮기기 같은 제어 경험을 전이한다. HL·VI는 긴 작업의 “다음 단계가 무엇인가”를 직접 감독한다. 각 데이터가 담당하는 일반화 축이 다르므로 제거 실험에서 평균 성공만 보면 중요한 차이를 놓치기 쉽다.
로봇 입출력과 실제 실행 조건
논문 §IV-E의 두 모바일 조작 플랫폼은 카메라 4개(전방·후방·각 손목), 2개의 6-DoF 팔, 그리퍼, 모바일 베이스 및 몸통 승강 장치를 갖는다. 관절과 베이스 속도 등을 포함한 상태·행동 공간은 플랫폼별로 18–19차원이라고 보고한다. 목표 명령을 50Hz로 추종하지만 추가적인 충돌 검사나 경로 계획은 없다는 한계도 함께 읽어야 한다.
새로운 환경 일반화는 어떻게 평가했는가
§V는 실험의 재현성을 위한 mock homes와 배포 현실성을 위한 unseen real homes를 분리한다. 장시간 작업은 하위 과제 진행률로 점수화되며, 특정 물체 집기·언어 지시 평가와 섞어 하나의 성공률로 해석하면 안 된다. 반복 횟수, 대상 집 수, 물체 범주 분포를 함께 보아야 한다.
실험과 주요 발견
저자는 약 100개 집에서 수집한 이동형 조작 데이터 약 400시간을 사용했지만, 사전학습 사례 중 목표 이동형 플랫폼의 가정 작업이 아닌 데이터가 97.6%였다고 보고한다. 최종 일반화는 훈련에 포함되지 않은 실제 집 3곳과 별도의 통제형 모의 주거 환경에서 평가했다. 실제 집 사례(원문 Figure 2, Figure 7)는 작업 중 고수준 소과제를 바꾸며 진행하는 모습을 보여주지만, Figure 2 한 장만으로 평균 성공률을 주장할 수는 없다. 데이터 구성 요소 제거 실험에서는 다른 로봇 데이터(ME/CE)가 전체 작업 수행에 중요했고, 웹 데이터(WD)는 특히 보지 못한 물체 범주의 언어 지시 수행 및 고수준 추론에서 영향을 보였다. (원문 §V-A–E)
Figure 2: 새로운 주방 정리 사례를 “성공률”로 오해하지 않기
저자 Figure 2는 학습에 없던 집의 주방에서 여러 과제를 수행하는 실행 프레임을 보여준다. 어떤 소과제를 선택하고 다음에 어떤 행동을 하는지 파악하는 데 적합하지만, 해당 이미지는 통계적 성공률 그래프가 아니다. 정량 성능은 §V와 Figure 7/10/13의 평가 조건을 따로 읽어야 한다.
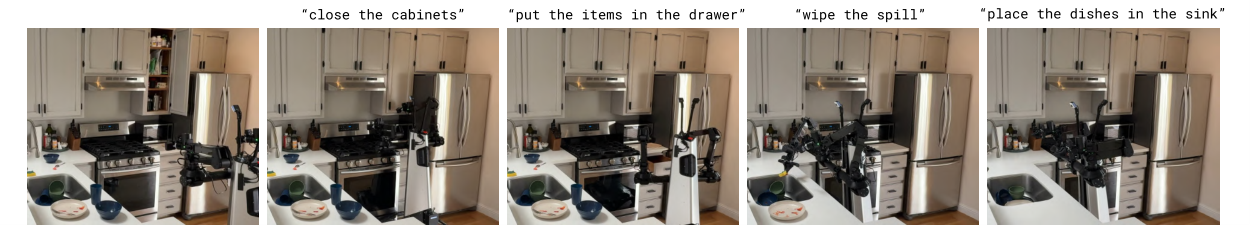
원문 캡션 일부 Fig. 2 : π 0.5 \pi_{0.5} cleaning a new kitchen. The robot is tasked with cleaning a kitchen in a home that…
- 01
① 새 환경: 학습에 쓰지 않은 집으로 장소가 바뀌었다는 점을 먼저 확인한다.
- 02
② 상위 목표: 서랍 닫기, 그릇 옮기기 같은 여러 작업이 큰 자연어 지시로 제공된다.
- 03
③ 중간 소과제: “접시 집기”처럼 언어로 표현된 작은 행동 목표가 선택된다.
- 04
④ 저수준 동작: 선택한 소과제에 조건부인 연속 동작 묶음이 실행된다.
- 05
⑤ 근거의 한계: 사례 시퀀스만 보고 모든 새로운 집에서 성공한다고 결론내릴 수 없다.
한국어 해설은 이해를 돕기 위한 편집 해석이며 저자 논문에서 검증된 수치나 그림의 모든 패널을 대체하지 않습니다.
실험 결과를 제대로 읽기
| 평가 항목 | 보고된 결과 | 해석 / 실험 조건 |
|---|---|---|
| 목표 플랫폼 학습 데이터 | 약 400시간 / 약 100개 집 | 원문 §IV-C의 MM 수집 규모. 전체 공동학습 데이터의 양은 이보다 큼. |
| 사전학습 데이터 구성 | 97.6%가 목표 이동형 가정 작업 외 데이터 | 원문 §I의 사전학습 비율. 다른 로봇 및 웹 등의 사례이며, 전체 데이터 중 로봇 행동 비율과 동일시하면 안 됨. |
| 학습 단계 | 280k 사전학습 + 80k 후속학습 | 원문 §IV-D. 단계 간 학습 목표와 데이터 혼합이 다름. |
| 실세계 평가 | 훈련에 없는 실제 집 3곳 | §V-A. 주방·침실을 포함한 장기 조작 과제를 평가. Figure 2는 사례 영상 프레임이며 평균 성공률 그래프가 아님. |
| 학습 장소 수 실험 | 3 / 12 / 22 / 53 / 82 / 104개 장소 | §V-B. 데이터 규모 효과와 장소 다양성 효과를 분리하려고 각 실험 40k steps 및 동일 고유 샘플 수로 비교. |
| 공동학습 요소 제거 | ME/CE 제거 시 성능 하락; WD 효과는 지표별 상이 | §V-C의 Figure 10–11. WD는 mock-home 전체 작업보다 OOD 물체 언어지시에서 중요. 단일 총점으로 합치지 말 것. |
| 고수준 추론 실험 | full π0.5 우수; implicit HL도 상당한 이득 | §V-E의 Figure 13. 같은 저수준 모델에서 high-level policy를 바꿔 비교하는 실험. |
ⓘ 이 표의 값은 논문 원문에 보고된 실험 조건을 요약한 것이다. Figure 2의 시연 장면과 Figure 7/10/11/13의 집계 결과는 구분해야 하며, 다른 모델과 성공률을 단순 비교하면 안 된다. 정량 막대 높이는 원문 그래프에서 확인한 경우에만 사용한다.
한계와 비판적 검토
일반화의 의미를 정확히 제한해야 한다. 테스트는 임의의 세상 전체가 아니라 특정 주거형 조작 작업과 실제 집 3곳, 통제된 모의 집들에 관한 것이다. 보고된 task progress는 모든 하위 단계를 완수하는 strict success rate와 같지 않다. 시스템은 목표 동작을 비교적 단순한 PD 제어기로 추종하고 추가적인 궤적 계획이나 충돌 검사를 사용하지 않았으므로 실제 배치 안전을 자동 보장하지 않는다. 공동학습 데이터의 다양성과 총량이 함께 바뀔 수 있어 모든 일반화 이득을 특정 요소 하나에 귀속하기도 어렵다. (원문 §IV-E, §V 및 부록)
내 연구에 적용한다면?
아래는 논문 저자의 검증 결과가 아니라, 논문에서 출발해 설계한 **후속 실험 제안**입니다.
[편집자 제안] 같은 demonstration budget에서 장면 다양성 확대가 새 물체 조작과 고수준 소과제 선택에 미치는 효과를 구분해 본다.
[편집자 제안] 고정형 팔 + 이동형 플랫폼 각각에서 환경 수, 전체 이미지/행동 샘플 수, 조작 과제군을 고정/변경하는 factorial 실험을 설계한다. train/test의 집·물체·언어 명령을 서로 분리한다.
[편집자 제안] target-only VLA, ME/CE 포함, +HL, +WD, +VI를 순차 비교하고 action expert 구조 및 최적화 budget은 최대한 고정한다.
[편집자 제안] task-progress와 strict success, OOD object language-following, subtask error, control latency, collision 및 recovery failure rate를 별도로 보고한다.
[편집자 제안] 다른 로봇의 데이터 품질/동작 스케일, 장면 다양성, 긴 작업 실패 확률, 고수준 오판이 교란변수가 된다.
원문을 읽으면서 확인할 4가지
- §IV-A: 수식의 ŝ(소과제)와 a(action chunk)가 각각 어떤 조건에 의존하는지 확인한다.
- Figure 3: 왼쪽 pretraining 데이터 출처와 오른쪽 posttraining의 동작 출력 표현을 구분한다.
- §IV-B Equation (1): 이산 토큰 CE와 연속 flow loss가 어느 단계에서 켜지는지 확인한다.
- §IV-C–D: MM/ME/CE/HL/WD/VI의 정의와 두 단계에서 포함 여부를 구분한다.
- §V-A / Figure 2·7: 보기 좋은 rollout 예시와 여러 회차의 정량 점수는 다른 수준의 근거다.
- §V-B: 위치 수가 늘면서 학습 샘플 수도 늘어나지 않았는지 통제 조건을 확인한다.
읽고 나서 남는 질문
- Figure 3의 1단계 FAST와 2단계 flow matching이 계산량·행동 정밀도에 각각 주는 영향은?
- ME와 CE를 빼면 어떤 물체·행동에서 실패가 증가하는가? Figure 10의 평가 단위를 확인해보자.
- Figure 11에서 WD가 OOD 물체에 주는 이득을 언어 이해와 실제 조작 정확도로 나눠 평가할 수 있을까?
- 새 집 3곳이라는 제한을 넘어, 조도·로봇 카메라·작업 길이 변화에 강건성을 측정하려면?
원문 / 출처 확인
편집자가 작성한 초록 기반 한국어 요약이며 공식 영문 초록의 원문/번역이 아닙니다.
저자 연구의 핵심 문제는 실험실 밖의 새로운 집에서 장시간 이어지는 로봇 조작 과제를 수행하는 일반화다. π0.5는 여러 로봇의 시연, 웹 시각·언어 데이터, 의미적 소과제 예측을 공통 아키텍처에서 함께 학습한다. 사전학습은 이산 액션 토큰으로 확장성을 확보하고, 후속학습에서는 연속 행동 생성을 위한 액션 전문가를 추가한다. 실제 새로운 주거 환경에서 계층적 하위 과제 추론과 로봇 동작 생성을 결합한 실험을 보고한다. 이 문단은 원문 초록의 직접 번역이 아닌 편집 요약이다.
해설은 논문 저자들의 진술과 편집자의 비판적 질문을 구분합니다. 특정 지표·인과관계·재현성을 판단할 때는 반드시 원문의 실험 설정을 확인해 주세요.