▧ 원문 §III–V, Figure 2·3과 대조한 편집 해설 · 독립 재현은 별도 · 상세 연구 노트 포함 · 원논문 Figure 문맥별 해설
핵심을 먼저 읽기
정답은 VLM을 무작정 더 빠르게 호출하는 것이 아니라, 오래된 의미를 들고도 즉시 다시 볼 수 있는 행동 루프를 학습하는 것이다. ARP의 성능 차이는 비동기 실행 자체와 stale-cache augmentation을 나누어 읽어야 설명된다(§3.1–3.4, Table 4).
핵심 독해 프레임: ARP는 더 큰 VLM 자체의 정확도 경쟁이 아니라 ‘VLM 대기시간이 제어 주기를 막는가?’를 바꾸는 실행 아키텍처 + 학습 분포 연구다. Table 1(정적 LIBERO), Table 2·3(동적 교란), Table 4(staleness ablation), Table 5(RTC) 및 Appendix A–D를 각각 고유한 조건으로 읽는다.
연구가 풀려는 문제
커다란 VLM이 어떤 컵을 집어야 하는지 알아내더라도, 그 추론이 끝날 때까지 로봇 팔이 멈춰 있으면 움직이는 물체를 놓친다. 예를 들어 그리퍼가 굴러가는 공을 향해 접근하는 순간 공을 옆으로 튕겨 놓으면, 동기 VLA는 다음 VLM 추론을 기다리는 사이 공이 이미 다른 위치에 있다. 기존 π0류의 순차 실행은 큰 의미 모델의 대기시간과 action expert 실행시간을 제어 주기에 합산한다. AsyncVLA·VLASH·RTC 등도 지연 완화에 접근했지만, ARP의 질문은 독립 프로세스로 실행하고 의미 캐시가 낡았음을 명시적으로 학습할 때 반응성과 정적 작업 성능을 함께 유지할 수 있느냐이다(§1–2).
핵심 아이디어
로봇을 두 개의 시계로 나눈다. 느린 시계의 semantic expert는 관측과 언어 명령을 읽고 layerwise K/V를 압축한 고정 폭 의미 메모리를 내보낸다. 빠른 시계의 vision-action expert는 그 메모리가 언제 만들어졌는지(age), 현재 카메라와 고유수용 감각, 실제 실행 지연을 함께 받고 행동 chunk를 즉시 다시 생성한다. 교실의 지시문은 천천히 갱신하되 현장 작업자는 눈앞 상황에 즉시 반응하는 것과 비슷하다. 다만 의미가 오래되면 작업 목표도 틀릴 수 있어 모델은 stale-cache 조건을 학습해야 한다(§3, Appendix A).
기존 연구와 무엇이 다른가?
π0형 동기 정책은 VLM과 expert 추론을 직렬화한다. ARP는 VLM 계산을 빠른 루프의 critical path에서 빼고 expert가 실시간 영상·과거 의미를 함께 본다는 점에서 ‘큰 모델의 출력 빈도만 낮춤’과 다르다. 반면 실시간 영상 경로 자체가 정책 성능을 바꿀 수 있으므로 이상적인 인과 검증은 시각 입력·체크포인트·학습 budget을 통제한 추가 실험을 요구한다. 본 연구는 전체 VLA의 정확도가 무조건 우월하다는 주장이 아니다.
방법론 · 아키텍처
§3 Eq.(1)에서 행동은 π_VA-E(I_t,s_t,M_τ,d_t,ℓ_t)로 정의된다. 느린 VLM은 여러 층의 K/V를 LNLinear·위치 임베딩·sinusoidal staleness embedding으로 변환해 고정 차원 M_τ를 만든다(Eq.2). 빠른 expert는 최신 agent/wrist 관측과 상태·register·noisy action token을 양방향 Transformer로 처리하며 각 층에서 memory에 cross-attention한다. Adaptive RMS Normalization은 diffusion/flow 단계, 캐시 나이, 실행 지연을 조건화한다. 학습할 때는 현재 영상 I_t와 같은 시연 궤적의 과거 영상 I_τ를 짝지어 d=t−τ를 0 또는 1…d_max 구간에서 샘플링한다(Eq.3). Flow matching은 action+Gaussian 혼합과 velocity 회귀(Appendix A Eq.5–6)를 사용하며, 이미 실행된 prefix를 보존하는 조건화로 재계획 사이의 연속성을 높인다. DROID에서는 VLM 한 번을 계산해 여러 시간 오프셋의 expert 타깃을 병렬 감독한다(Appendix D).
모델 구조와 처리 흐름
개념적 처리 순서를 정리한 편집 다이어그램이며 원논문의 그림을 복제한 것은 아닙니다.
- 01
1. 빠른 루프에서 필요한 정보와 느린 루프의 지시를 분리
시점 t의 제어 입력은 현재 RGB I_t, 로봇 관절·그리퍼 상태 s_t, 이전 시점 τ의 메모리 M_τ다. 명령이 단순해도 주변 움직임은 제어 루프마다 바뀐다. 그래서 action expert의 forward pass에 VLM backbone 계산을 넣지 않는다.
현재 I_t,s_t + 메모리 M_τ + age d_t + execution lag ℓ_t - 02
2. semantic expert의 K/V 압축
VLM은 자연어 명령과 선택된 카메라 관측을 처리한다. 여러 Transformer 층의 K/V cache를 LNLinear로 고정 폭 S×D 메모리로 사상하고 공간·시간 임베딩을 합친다. 사전학습 언어 판단과 저수준 제어를 분리하는 인터페이스다.
§3.2 Eq.(2): KV_τ → LNLinear + P + E_stale(d) - 03
3. fast Vision-Action Expert의 독립 추론
빠른 쪽은 현재 에이전트/손목 카메라, proprioception, register, 행동 chunk 토큰을 입력한다. 양방향 Transformer 각 층의 cross-attention은 마지막으로 도착한 의미 메모리를 참조하며 AdaRMS가 flow noise 단계·memory age·lag를 반영한다.
실시간 시각 토큰 → cross-attend(M_τ) → H×A action chunk - 04
4. stale-cache sampling으로 시간 간극을 학습
학습에서 현재 I_t와 같은 데모 중 과거 I_τ를 섞어 제어 입력을 만든다. Eq.(3)은 0 지연 확률 p0와 양의 d∈{1,…,d_max} 균등분포의 혼합이다. 지연이 전혀 없는 학습은 단순한 분리 아키텍처만으로 대기시간에 강하지 못하다.
훈련: sampled d_t,ℓ_t → 실제 비동기 배포의 시간 불일치 모사 - 05
5. flow matching과 실행 prefix의 합성
Appendix A의 clean context와 noisy actions에 서로 다른 flow-step embedding을 넣어 velocity를 회귀한다. 재계획 시 이미 실행한 행동 prefix를 noise-free로 고정하는 prefix conditioning은 chunk 경계에서 손끝 움직임이 급변하지 않도록 도와준다.
Appendix A Eq.(5–6) + prefix conditioning - 06
6. 성능을 분리해 측정
정적 성공률(LIBERO 40 tasks), 타깃 5cm 이동(LIBERO-Perturb), 속도 충격(Dynamic-Bump), 실제 Franka 3개 물체 넣기·컵 쌓기 과제, RoboLab의 성공·수행 시간·jerk는 서로 다른 endpoint다. 한 표의 절대 점수로 다른 실험을 대체하지 않는다.
Table 1–6, Appendix B/C/D의 episode·time budget 확인
핵심 설계·학습 신호 해설
고정 폭 의미 메모리의 역할
큰 언어 모델은 S×D 메모리만 내보내고 fast expert는 이 고정된 크기의 메모리에 cross-attend한다. VLM 크기를 바꾸어도 action path의 깊이와 실행시간이 선형으로 같이 늘지 않게 하려는 구조적 선택이다. 다만 최신 메모리가 도착하기 전에는 과거의 판단을 계속 쓴다.
아키텍처만 분리하면 충분하지 않다
Table 4에서 Sync-only 학습은 VLM이 드물게 갱신될 때 거의 실패한다. 0.5Hz에서 d=0 모델 2.0%, d~U(1…40) 81.8%, d~U(1…80) 86.5%. 효과는 구조 자체 + 시간 차이 학습의 결합이다.
이동 타깃 교란의 두 종류
LIBERO-Perturb는 end-effector와 target 거리가 10cm 이내면 5cm를 수직 방향으로 이동시키며, Appendix B에서는 step 120 fallback도 정의한다. Dynamic-Bump는 rolling object heading을 ±100° 범위에서 변경한다. 하나는 순간적인 위치 갱신, 하나는 속도 방향 충격이라 실패 기제가 다르다.
DROID 실물과 RoboLab의 지표 분리
실물 Franka는 DROID 플랫폼 3개 과제이고 Figure 3은 정성·정량 패널을 묶는다. Table 5의 31.9→37.5%는 별도의 RoboLab ARP-3B 체크포인트에서 prefix RTC의 영향이다. RoboLab Table 6 전체에서도 외부 데이터 pretrained 모델이 더 높은 점수를 낼 수 있다.
실험과 주요 발견
LIBERO 40과제·4 suite, suite당 500 episode의 Table 1에서 동일 설정 재구현 π0-1B 평균 성공률은 80.2%, ARP-1B는 84.8%, ARP-8B는 89.3%다. 별도 대형 pretrained π0의 94.2%는 다른 학습 조건이므로 직접 통제 비교가 아니다. LIBERO-Perturb의 목표 5cm 이동 뒤 성공은 π0-1B 9.5% 대 ARP-1B 51.5%(Table 3). Dynamic-Bump에서 반드시 충격(p=1)일 때 12.7% 대 44.7%, 확률 p=0.5일 때 20.0% 대 46.7%(Table 2). 가장 결정적인 ablation은 Table 4: 지연 없이 훈련한 모델은 VLM 0.5Hz에서 2.0%로 붕괴하지만 지연 1…40 frame 학습은 81.8%, 1…80 학습은 86.5%다. RoboLab의 별도 DROID 기반 3B 체크포인트에서 prefix RTC 적용 성공률은 31.9→37.5%, 실행시간 19.5→17.1초(Table 5). 원논문 Figure 3의 실물 Franka 사례와 Figure 4의 이동 물체 정성 장면은 이 집계와 따로 읽어야 한다.
Figure 3 — DROID 기반 실제 Franka와 RoboLab의 별도 결과
저자 Figure 3은 실물 Franka 과제와 RoboLab 시뮬레이션 결과를 묶는다. 막대나 장면을 볼 때 각 평가의 task budget과 점수 정의가 다르므로, Table 5의 RoboLab 31.9→37.5%를 실물 Franka 성공률로 바꾸어 읽으면 안 된다.
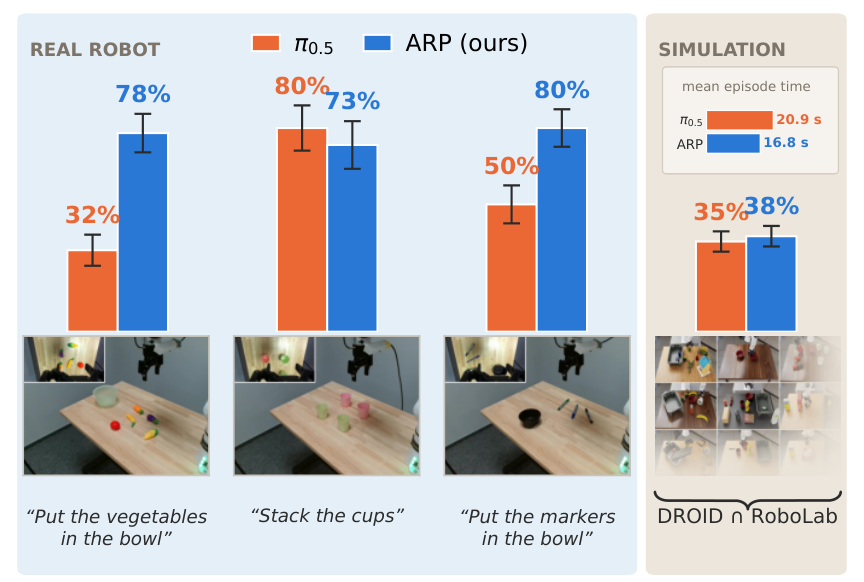
원문 캡션 일부 Figure 3: Franka Evaluation Results on Real-world experiments and RoboLab simulation.
- 01
실물 로봇 예시와 RoboLab 패널을 구별한다.
- 02
DROID 학습 ARP와 π0.5-DROID의 pretrained 데이터 조건 차이를 확인한다.
- 03
실물 vegetables/markers 넣기의 진척도와 RoboLab 완료율 지표를 구별한다.
- 04
Table 5의 prefix RTC 개선과 Figure 3의 정성 설명을 별도 증거로 둔다.
한국어 해설은 이해를 돕기 위한 편집 해석이며 저자 논문에서 검증된 수치나 그림의 모든 패널을 대체하지 않습니다.
Figure 4 — 움직이는 공을 재탐지하는 비동기 제어
원문 Figure 4는 Dynamic-Bump 한 시행의 프레임을 보여준다. ARP가 튕겨 나간 공을 재추적한 장면이며 확률적 충격의 전체 성공률은 Table 2의 p=1, p=0.5 행으로 평가한다.
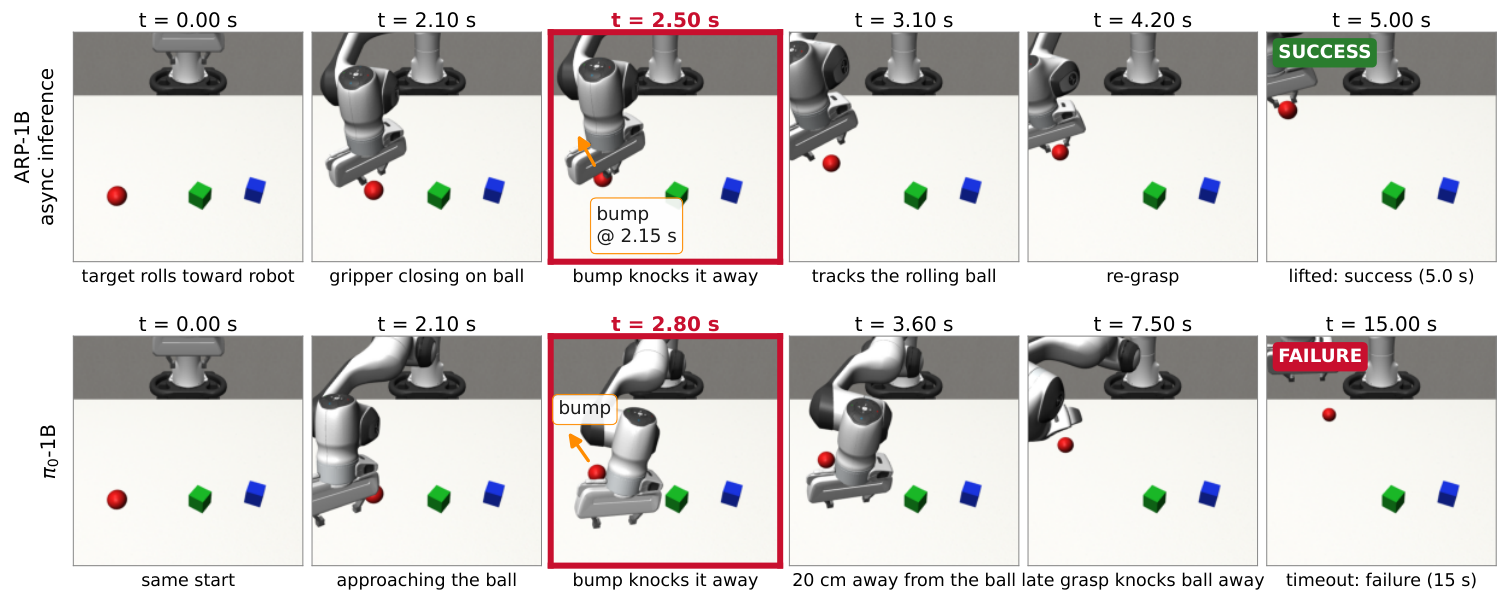
원문 캡션 일부 Figure 4: Qualitative example of Dynamic-Bump task. After bumping the ball, ARP is able to react in time to grasp it whereas…
- 01
충격 전에 설정된 접근 경로와 이후 ball 위치를 비교한다.
- 02
동기 π0-1B가 실패한 프레임을 찾되 전체 성능 추론으로 확장하지 않는다.
- 03
p=1에서 44.7% 대 12.7%, p=0.5에서 46.7% 대 20.0%를 Table 2에서 확인한다.
- 04
Appendix C의 heading rotation ±100° 및 20Hz controller를 같이 확인한다.
한국어 해설은 이해를 돕기 위한 편집 해석이며 저자 논문에서 검증된 수치나 그림의 모든 패널을 대체하지 않습니다.
실험 결과를 제대로 읽기
| 평가 항목 | 보고된 결과 | 해석 / 실험 조건 |
|---|---|---|
| LIBERO 정적 · Table 1 | ARP-1B 84.8% / π0-1B 재구현 80.2% | 40 tasks, 4 suites, suite당 500 episodes. 외부 pretrained π0 94.2%와 무통제 비교 금지 |
| LIBERO 대형 backbone | ARP-8B 89.3%, ARP-14B 89.1% | Table 1. frozen InternVL visual encoder로 backbone scale 비교 |
| LIBERO-Perturb · Table 3 | 51.5% vs 9.5% | ARP-1B vs π0-1B; target 거리 10cm 전후 5cm 옆으로 이동, 별도 시뮬레이션 |
| Dynamic-Bump · Table 2 | 44.7% vs 12.7% (p=1) | 항상 이동속도 충격; p=0.5에서 46.7% vs 20.0% |
| Staleness ablation · Table 4 | 0.5Hz: 2.0% / 81.8% / 86.5% | 훈련 d=0 / U(1..40) / U(1..80), 1B 동일 실험, cell당 500 episode |
| DROID RoboLab prefix RTC · Table 5 | SR 31.9→37.5%, time 19.5→17.1s | ARP-3B checkpoint의 prefix on/off; ISJ 456→296 |
| DROID 실물 Franka | 실물 3과제에서 진척·효율 해석 | Figure 3 및 Appendix D, Table 5 RoboLab 수치를 실물 성공률로 대체하지 않음 |
| GPU 추론 지연 · Appendix A | VLM 약 64–125ms; fast expert 약 55ms | A6000 실측 범위, 모델 및 Euler step별 차이, end-to-end 통신 비용 별도 |
ⓘ 표의 SR은 각 벤치마크의 episode 단위 완료율이다. RoboLab의 time/score, Franka 물체 수, Figure 4 정성 성공 예시는 동일 모집단에서 구한 수치가 아니다. 논문은 저자 결과이며 독립 재현이 없다.
한계와 비판적 검토
모든 결과가 같은 데이터·모델 크기·평가에 해당하지 않는다. LIBERO/Dynamic-Bump는 시뮬레이션이고 Franka 실제 로봇은 3과제로 제한된다. Table 1의 π0 pretrained 94.2%와 ARP 84.8%를 빼서 보편적 성능 우월을 말할 수 없다. RoboLab Table 6에는 외부 pretrained π0.5 37.9%, ARP-3B 20.0%가 함께 등장하므로 모든 플랫폼에서 ARP가 절대적으로 더 우수하다는 주장은 틀린다. Appendix D는 RoboLab 120 task×8 layout=960 episode와 DROID 커버리지의 문자열 기반 프록시를 밝힌다. Figure 4는 한 예시이지 성공률 증명이 아니다. 지연 보정은 메모리 인계, 안전 중단, 신선한 지시 반영 등 시스템적 병목을 제거하지 않는다.
내 연구에 적용한다면?
아래는 논문 저자의 검증 결과가 아니라, 논문에서 출발해 설계한 **후속 실험 제안**입니다.
로봇의 실시간 시각을 독립 action path에 넣고 cache age를 함께 학습하면 VLM 업데이트가 5Hz→0.5Hz로 떨어져도 교란 대응 성능이 유지된다.
동일 vision encoder·VLM·데이터·GPU에서 ①동기 π0-style ②fast path만 분리·staleness 0 ③staleness 1..40 ④1..80을 3 seed 이상 훈련한다. LIBERO-Perturb 5cm/10cm 및 Dynamic-Bump 0.5/1.0, 실물 Franka interrupt 시나리오로 시험한다.
동일 backbone 동기 VLA, dual-path+cache but no stale training, stale training full, prefix RTC on/off, 영상 입력 동일 조건의 정책
strict success, 교란 후 회복 시간, 99th-percentile action latency, GPU 비용, jolt/jerk, VLM 갱신 후 의미 전파 지연, 실물 안전 정지 횟수
stale memory가 잘못된 물체를 선택할 위험이 있으며, 영상 timestamp 드리프트와 통신 장애, 안전 인터록 없는 실물 교란은 금지한다.
원문을 읽으면서 확인할 4가지
- §3 Eq.(1)의 M_τ,d_t,ℓ_t를 표시하고 ‘현재 영상’과 ‘과거 의미’의 결합을 설명한다.
- §3 Eq.(2)와 Appendix A의 staleness embedding이 단순한 timestamp 표시에 그치지 않는지 확인한다.
- Table 1의 π0 94.2%와 동일 규모 π0-1B 80.2%가 다른 비교군인 이유를 표시한다.
- Table 2·3에서 Dynamic-Bump와 LIBERO-Perturb의 교란 발생 조건을 구분한다.
- Table 4의 staleness distribution 행을 0.5Hz 열과 대조해 구조-only 대조군을 찾는다.
- Figure 3(실물·RoboLab), Figure 4(정성 bump)를 보기 전에 평가 플랫폼을 표에 적는다.
읽고 나서 남는 질문
- 빠른 expert가 보는 wrist/agentview와 느린 VLM의 단일 카메라 간 차이가 reactivity 향상에 얼마나 기여하는가?
- Table 4에서 1…80 frame stale 학습의 정적 성능 81.0%는 1…40의 85.2%보다 낮다. 언제 업데이트 비용과 성능을 trade-off할까?
- Table 2의 p=1 충격과 Table 3의 5cm 순간 이동은 물리적으로 어떤 종류의 교란이 다른가?
- Figure 3의 Franka 3과제에서 정량 성공의 기준은 무엇이며 RoboLab 960회와 분리되는가?
- 고수준 목표가 중간에 바뀌는 instruction interrupt에서도 낡은 semantic memory가 위험하지 않은가?
원문 / 출처 확인
편집자가 작성한 초록 기반 한국어 요약이며 공식 영문 초록의 원문/번역이 아닙니다.
실시간 로봇에서 언어·시각 파운데이션 모델의 추론 지연을 제어 경로에서 제거할 수 있는가? ARP는 VLM이 드물게 갱신하는 의미 메모리를 빠른 Vision-Action Expert가 사용하는 이중 비동기 루프다. 이 문장은 저자 초록의 기계 번역이 아니라 Method·Experiment·Appendix를 교차해 편집한 요약이다.
해설은 논문 저자들의 진술과 편집자의 비판적 질문을 구분합니다. 특정 지표·인과관계·재현성을 판단할 때는 반드시 원문의 실험 설정을 확인해 주세요.