▧ 원문 §III–V, Figure 2·3과 대조한 편집 해설 · 독립 재현은 별도 · 상세 연구 노트 포함 · 원논문 Figure 문맥별 해설
핵심을 먼저 읽기
Octo의 핵심은 로봇마다 다른 입력 센서·언어 목표·행동 차원을 바꾸더라도 큰 정책 표현을 최대한 재사용하는 것이다. Goal image와 language instruction을 같은 Transformer에 넣고, readout head로 연속 행동을 생성한다. (원문 §III)
읽는 목표: Octo는 ‘80만 궤적으로 학습한 로봇 GPT’라는 한 줄 요약보다 재사용 가능한 입출력 인터페이스가 핵심이다. 그림을 먼저 훑지 말고, Task·Observation·Readout 토큰이 각각 무엇인지 이해하고 PDF Figure 2에서 색을 따라 읽는다. 다음으로 PDF Figure 3의 데이터 가중치와 두 가지 실험표의 평가 단위를 분리한다.
연구가 풀려는 문제
서로 다른 로봇을 다루려면 단지 모델 파라미터 수만 늘려서는 부족하다. 어떤 로봇은 전방 카메라만 있고 다른 로봇은 손목 카메라·관절 센서가 있으며, 출력도 TCP delta, joint command처럼 다르다. 로봇별 정책을 모두 처음부터 재학습하면 필요한 시연과 계산비용이 커진다. Octo는 유연한 토큰 구조와 action readout을 통해 많은 데이터에서 얻은 경험을 다른 로봇으로 옮길 수 있는지 묻는다. (§I, III-A)
핵심 아이디어
Task tokenizer는 언어 지시나 목표 이미지를 표현하고 Observation tokenizer는 관측을 토큰으로 바꾼다. Transformer가 이 토큰들을 block-wise attention으로 처리해 readout 토큰에 행동 예측에 필요한 정보를 모은다. 이후 작은 diffusion action head가 연속 동작을 생성한다. 로봇을 옮길 때 새 센서 토큰과 action head를 추가할 수 있다. 이 구조는 PDF Figure 2의 녹색(Task), 파란색(Observation), 보라색(Readout)을 따라가면 보인다. (§III-A)
기존 연구와 무엇이 다른가?
OpenVLA는 7B LLM을 사용해 이산 action token을 생성한다. Octo는 27M/93M의 모듈형 토큰과 diffusion head를 통해 다양한 로봇 센서·행동 공간으로 적응하는 것을 중심으로 설계한다. π0는 pre-trained VLM과 별도 action expert로 연속 행동을 flow matching한다. 셋의 성공률을 서로 다른 로봇·데이터로 직접 비교할 수는 없다.
방법론 · 아키텍처
Open X-Embodiment에서 이미지·말단 동작 등이 일관되게 존재하는 25개 데이터셋, 약 80만 trajectory를 골라 사전학습한다. 데이터셋마다 크기와 다양성이 달라 각 미니배치에 기여하는 샘플링 가중치를 조절했다. PDF Figure 3의 파이차트는 그 가중치이지 전체 파일 크기 비율이 아니다. Transformer의 readout 표현을 조건으로 한 작은 action head 안에서 20회 DDPM denoising을 사용한다. 이는 Transformer 전체를 20번 실행한다는 뜻이 아니다. (§III-B–D)
모델 구조와 처리 흐름
개념적 처리 순서를 정리한 편집 다이어그램이며 원논문의 그림을 복제한 것은 아닙니다.
- 01
1. 다른 로봇 데이터를 같은 규격으로 큐레이션
카메라 관측, 로봇 말단 제어가 존재하는 Open X-Embodiment의 25개 데이터셋에서 약 80만 trajectory를 모은다. 단순 concat이 아니라 불일치하는 로봇 인터페이스·그리퍼 정의를 정리한다.
25 datasets · ~800K trajectories - 02
2. 목표를 Task Token으로 바꾸기
입력 목표가 언어면 사전학습 언어 인코더를, 이미지면 경량 CNN을 거쳐 task token을 만든다. ‘컵을 집기’와 ‘목표 상태 사진 따라가기’를 다른 표현으로 지원한다.
instruction or goal image → task tokens - 03
3. 관측을 Observation Token으로 바꾸기
이미지와 optional proprioception을 token화한다. 서로 다른 시점·카메라 개수를 token 구성으로 다룰 수 있도록 설계했다. 새 로봇 센서가 들어오면 해당 경로를 확장할 수 있다.
RGB / sensors / history → observation tokens - 04
4. Transformer의 Readout에서 행동 정보 추출
Block-wise attention은 토큰끼리 참고하는 범위를 구조화한다. Readout token이 출력 헤드에 필요한 표현을 모으고, 새 action space는 새 헤드로 매핑할 수 있다.
task+observation → transformer → readout - 05
5. 작은 Diffusion Head로 연속 행동 생성
Transformer 표현을 조건으로 출력 head가 시간축의 연속 action chunk를 복원한다. 학습 과정에서는 동작에 노이즈를 넣고, 추론 시 작은 head 안에서 DDPM 20-step denoising을 진행한다. 전체 backbone을 20회 호출하는 구조와 다르다.
readout → diffusion action chunk
PDF Figure 2 — Task·Observation·Readout token
§III-A의 구조 설명 뒤 원본 PDF Figure 2를 본다. arXiv HTML 자동 번호와 다를 수 있어 PDF 인쇄 번호를 표기한다.
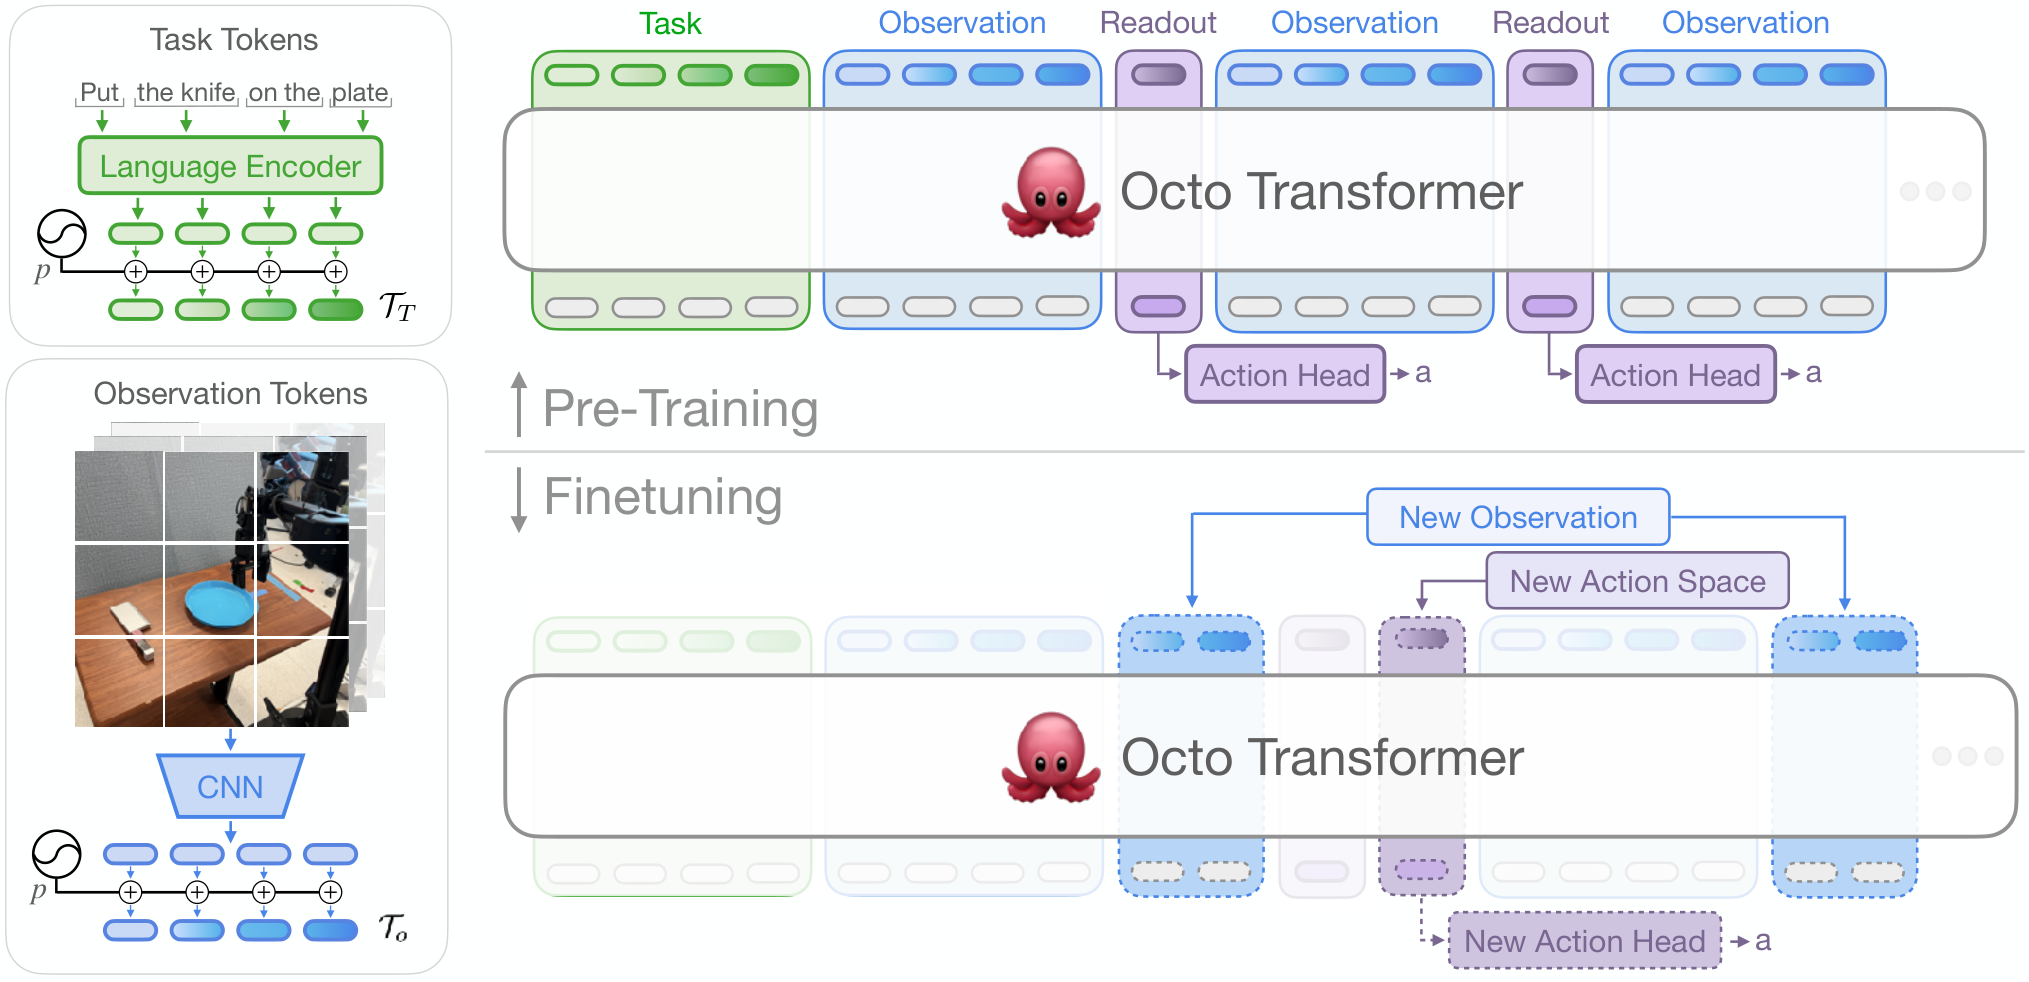
편집 캡션 요약 Task/observation tokenizers, Transformer readout, flexible action head 구성.
- 01
녹색은 언어 명령 또는 목표 이미지에서 만든 Task token이다.
- 02
파란색은 카메라·로봇 상태의 Observation token이다.
- 03
중앙 Transformer가 관계를 처리하고 보라색 Readout token으로 행동 조건을 전달한다.
- 04
작은 diffusion action head에서 연속 행동을 생성한다. Backbone을 20번 돌리는 뜻이 아니다.
- 05
아래 점선은 새로운 센서와 동작 출력 헤드를 추가할 수 있다는 모듈성을 뜻한다.
한국어 해설은 이해를 돕기 위한 편집 해석이며 저자 논문에서 검증된 수치나 그림의 모든 패널을 대체하지 않습니다.
PDF Figure 3 — 25개 데이터셋의 학습 샘플링 가중치
§III-B에서 사전학습 데이터 큐레이션을 읽고 Figure 3 파이차트를 보자. 저장된 전체 자료량이 아니라 미니배치 샘플링 비율이다.
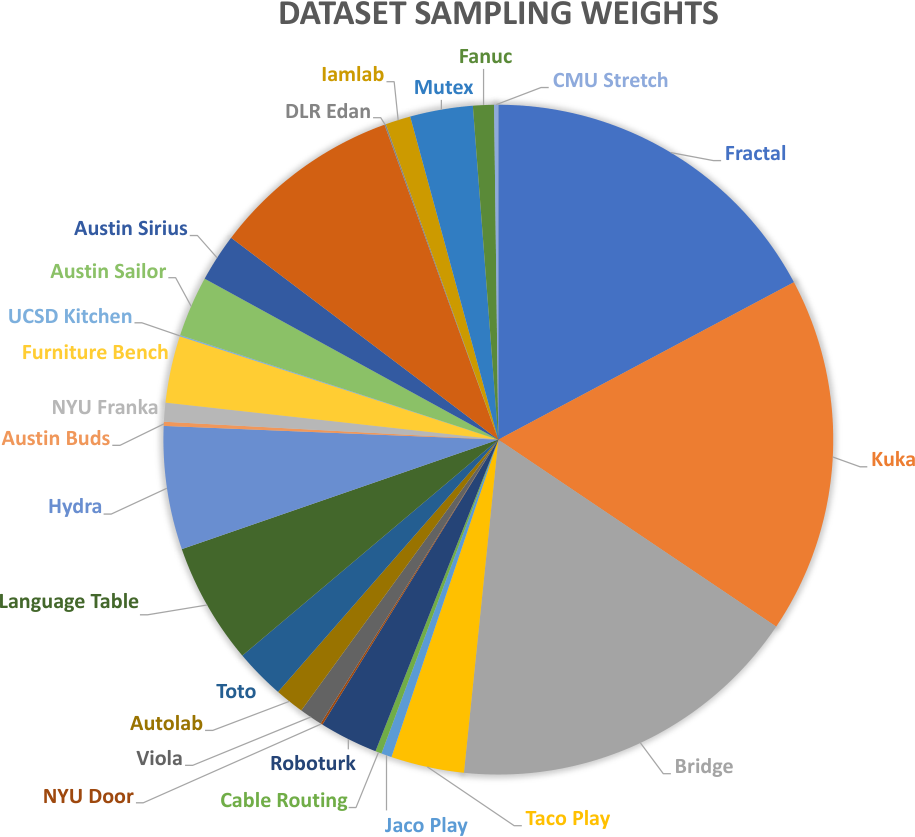
편집 캡션 요약 25 curated Open X-Embodiment datasets의 학습 미니배치 평균 기여 비율.
- 01
Image observation과 로봇 말단 행동을 제공하는 데이터셋을 선별했다.
- 02
각 dataset의 크기뿐 아니라 행동 다양성을 고려해 batch sampling weight를 조정한다.
- 03
파이차트의 면적은 실제 정책 학습 배치의 기여 비율이다.
- 04
큰 데이터셋이 반드시 높은 비율을 의미하지는 않는다.
- 05
Table II의 데이터 혼합 ablation과 연결해 해석하고 인과관계를 과장하지 않는다.
한국어 해설은 이해를 돕기 위한 편집 해석이며 저자 논문에서 검증된 수치나 그림의 모든 패널을 대체하지 않습니다.
핵심 설계·학습 신호 해설
PDF Figure 2의 색을 읽는 법
왼쪽 녹색 토큰은 Task, 파란색은 Observation이다. 중앙 Transformer가 이 표현들을 처리한 뒤 보라색 Readout 토큰이 출력으로 흘러간다. 아래 점선 경로는 새로운 observation 또는 action interface를 추가하는 상황을 예시한다. 이 아키텍처는 task 종류가 달라질 때 모델을 유연하게 수정하기 위한 설계다.
PDF Figure 3의 파이차트 의미
각 조각은 원본 파일 시스템에서 차지하는 용량이 아니라, 학습 미니배치에서 해당 데이터셋을 얼마큼 샘플링하는지의 비중이다. 크기가 큰 데이터셋이 반드시 더 높은 sampling weight를 받는 것이 아니다. 데이터 다양성 확보가 왜 효과가 있는지는 Table II와 함께 검토한다.
Diffusion head와 Backbone 계산 분리
거대한 Transformer는 토큰 정보를 한 번 계산하고, 상대적으로 작은 출력 head가 조건부 생성 과정을 반복한다. 이는 20번의 denoising step을 20개의 제어 프레임이나 20회의 큰 Transformer 호출로 오해하지 않도록 해준다.
Table I/II가 서로 다른 실험인 이유
Table I은 새 로봇 도메인에 작은 시연 데이터로 미세조정한 결과의 평균이다. Table II는 WidowX 4과제에서 학습 데이터 혼합·head 종류 등을 바꾸는 ablation이다. 서로 표본 공간·설정이 다르므로 72%와 83%를 한 모델의 단순 향상 수치처럼 연결하면 잘못이다.
실험과 주요 발견
저자들은 9개 로봇 플랫폼을 대상으로 제로샷 및 새로운 로봇 도메인에 적응하는 능력을 평가했다. Table I의 6개 미세조정 도메인 평균 성공률은 Octo 72%, 처음부터 학습 20%, VC-1 15%로 보고한다. 도메인별 시연 약 100개, 성공률은 20회 시도에 기반한다. 다른 실험인 WidowX 4과제 Table II에서는 Octo-Small 83%, RT-X 데이터 혼합 60%, Bridge만 학습 43%이고, diffusion을 MSE head(35%) 또는 이산 head(18%)로 바꿨을 때도 성능 차이가 나타났다. 두 표의 수치를 하나의 동일한 평가인 것처럼 합치면 안 된다. (§IV, Table I–II)
실험 결과를 제대로 읽기
| 평가 항목 | 보고된 결과 | 해석 / 실험 조건 |
|---|---|---|
| 사전학습 | 약 800K trajectories / 25 datasets | Open X-Embodiment에서 정제, §III-B |
| 새 도메인 Fine-tuning | Octo 72% vs Scratch 20% vs VC-1 15% | 6개 로봇 도메인 평균, 도메인별 약 100 demos/20 trials, Table I |
| 데이터 혼합 Ablation | Octo-Small 83% / RT-X 60% / Bridge 43% | WidowX 4과제, 총 40 trials, Table II |
| Action Head Ablation | Diffusion 83% / MSE 35% / Discrete 18% | WidowX 4과제, Table II |
| 모델 크기 | 27M Small / 93M Base | 사전학습 크기가 다르므로 fine-tuning 계산량도 별도 비교 |
ⓘ 72%는 6개 downstream 도메인 미세조정 평가 평균, 83%는 WidowX 4과제 ablation이다. 결과의 평가 단위와 로봇 구성이 다르다.
한계와 비판적 검토
데이터가 매우 이질적이기 때문에 입력 카메라 이름, action coordinate frame, gripper 의미를 맞추는 전처리 선택이 중요하다. 성공률은 원문에서 명시한 과제와 시연 예산에 한정되고, 새로운 로봇이면 항상 72%를 보장한다는 뜻이 아니다. 목표 이미지와 언어 지시의 질, 긴 작업에서의 실패 복구, fine-tuning 계산량도 별개로 측정해야 한다. (Appendix E–F)
내 연구에 적용한다면?
아래는 논문 저자의 검증 결과가 아니라, 논문에서 출발해 설계한 **후속 실험 제안**입니다.
새 로봇 센서를 추가하더라도 토큰 인터페이스 수정만으로 기존 backbone 표현을 재사용할 수 있을 것이다.
같은 target 로봇에서 관측 카메라·힘 센서를 점진적으로 늘리며 약 100개 데모로 정책을 적응시킨다.
원형 토큰 구성 / 새 토큰+고정 backbone / 새 토큰+전체 fine-tune / scratch, 동일 출력 head
성공률, GPU·시간, sensor dropout, OOD 목표물, latency
좌표계·타임스탬프 정렬 오류가 아키텍처 효과를 가릴 수 있어 데이터 품질을 통제한다.
원문을 읽으면서 확인할 4가지
- PDF Figure 2에서 녹색 Task·파란 Observation·보라 Readout token이 어디에서 생성되고 소비되는지 표시한다.
- PDF Figure 3이 전체 데이터 용량이 아니라 배치 샘플링 가중치임을 확인한다.
- §III-C의 20-step DDPM은 작은 action head의 생성 반복임을 구분한다.
- Table I의 6개 도메인 Fine-tuning과 Table II의 WidowX ablation을 별도 기록한다.
읽고 나서 남는 질문
- PDF Figure 2에서 토큰형 입력만 바꾸고 backbone을 유지할 때 어떤 정보가 공유되는가?
- PDF Figure 3의 데이터 가중치를 바꾸면 후속 학습 성능은 어떻게 달라지는가?
- DDPM action head의 20회 denoising이 실제 로봇 제어 지연의 어느 부분을 차지하나?
- Table I과 II의 72%와 83%가 왜 같은 성공률 지표가 아닌가?
원문 / 출처 확인
편집자가 작성한 초록 기반 한국어 요약이며 공식 영문 초록의 원문/번역이 아닙니다.
원문 초록의 직역이 아니라 Method, 실험표 및 Figure를 바탕으로 작성한 한국어 기술 해설이다. 정량 결과는 저자의 보고이며, 재현 검증은 별도로 필요하다.
해설은 논문 저자들의 진술과 편집자의 비판적 질문을 구분합니다. 특정 지표·인과관계·재현성을 판단할 때는 반드시 원문의 실험 설정을 확인해 주세요.