▧ 원문 §III–V, Figure 2·3과 대조한 편집 해설 · 독립 재현은 별도 · 상세 연구 노트 포함 · 원논문 Figure 문맥별 해설
핵심을 먼저 읽기
OpenVLA는 시각·언어 사전학습 표현을 실제 로봇의 7차원 제어로 연결하는 공개 7B VLA다. 중요한 차별점은 단순한 성능 점수가 아니라, 여러 로봇의 시연 데이터로 학습된 공개 가중치와 파인튜닝 가능한 행동 인터페이스라는 점이다. (§1–3)
읽는 목표: OpenVLA가 LLM 위에 카메라를 붙인 단순 챗봇이 아니라, 행동 좌표를 토큰으로 학습한 제어 정책임을 이해하자. (1) 영상·언어 입력, (2) 시각 특징 정렬, (3) 이산 행동 토큰 생성, (4) 실험 조건이라는 네 구간을 따라가면 PDF Figure 2를 해석할 수 있다. 수치는 논문의 평가 조건과 짝지어 읽는다.
연구가 풀려는 문제
로봇이 언어 지시와 영상에서 행동을 만들려면, 시각적 의미와 로봇 좌표계의 연속적인 움직임을 함께 다뤄야 한다. 과거 큰 VLA의 가중치가 공개되지 않아 같은 환경에서 실험을 재현하거나 다른 로봇에 적응하는 작업이 어려웠다. OpenVLA는 ‘웹 이미지로 이해하는 능력’과 ‘로봇 시연에서 행동을 예측하는 능력’을 하나의 모델 안에 묶어 이 문제를 풀려고 한다. 단, 공개 여부와 로봇에서의 성공률은 별개의 평가 항목이다. (§1–2)
핵심 아이디어
왼쪽 카메라 이미지를 DINOv2와 SigLIP 두 시각 인코더가 서로 다른 관점으로 해석하고, 결합한 특징을 MLP Projector가 언어 토큰 공간으로 투영한다. Llama 2 7B는 이미지와 자연어 목표를 조건으로 ‘다음 단어’ 대신 ‘다음 로봇 행동 토큰’을 예측한다. 로봇이 실제로 실행하는 연속 명령은 마지막에 이산 토큰을 다시 역변환한 것이다. 아키텍처가 PDF Figure 2에 그려져 있다. (§3.1–3.2)
기존 연구와 무엇이 다른가?
Octo는 입력/출력을 교체하기 쉬운 token/readout 정책과 diffusion head에 초점을 맞춘다. OpenVLA는 Llama 2의 다음 토큰 예측을 7D 이산 행동으로 바꾼다. π0는 VLM과 action expert를 분리하고 연속 행동 chunk를 flow matching으로 생성한다. 데이터·평가 로봇이 다르므로 모델 간 숫자 한 줄로 우열을 정하면 안 된다.
방법론 · 아키텍처
입력은 관측 이미지 I와 언어 지시 ℓ이다. 이미지 특징을 두 비전 인코더로 계산해 합치고 projector를 거쳐 Llama 2와 정렬한다. 로봇 시연의 7개 행동 차원(위치, 자세, 그리퍼)을 학습 데이터의 각 차원 1~99 백분위 범위로 잘라 256개 구간에 양자화하고, 언어 모델의 드문 토큰 256개를 이 행동 값의 표지로 재활용한다. 네트워크는 행동 토큰을 순차 예측하도록 cross-entropy로 학습한다. 추론은 7개 토큰을 수치로 되돌려 로봇 제어 명령을 구성하는 과정이다. Flow Matching이나 Diffusion을 사용하는 모델과 가장 큰 설계 차이가 여기 있다. (§3.2–3.3)
모델 구조와 처리 흐름
개념적 처리 순서를 정리한 편집 다이어그램이며 원논문의 그림을 복제한 것은 아닙니다.
- 01
1. 이미지와 언어를 받아 상황을 정의
RGB 관측 I와 ‘컵을 오른쪽으로 옮겨’ 같은 언어 지시 ℓ가 주어진다. 이 입력은 대상 물체와 목표를 정할 뿐, 현재 로봇의 충돌 없는 궤적을 미리 계산하지 않는다.
Iₜ + instruction ℓ - 02
2. DINOv2와 SigLIP 비전 인코더 병렬 실행
동일 영상 패치가 두 시각 인코더를 통과한다. DINOv2는 영상의 일반적인 시각 특징을, SigLIP은 언어와 가까운 시각 의미를 학습한 백본이다. 모델은 특징을 이어 붙여 한쪽만 사용할 때 놓치는 신호를 보완하려 한다.
[DINOv2(I), SigLIP(I)] - 03
3. MLP projector로 LLM 입력 임베딩에 정렬
서로 다른 차원의 이미지 특징을 Llama 2가 언어 토큰과 함께 읽을 수 있는 표현으로 변환한다. Projector 자체가 7차원 로봇 제어를 직접 예측하는 것은 아니다.
visual features → language-aligned embeddings - 04
4. Llama 2가 7개 행동 차원용 토큰 예측
각 연속 행동 차원을 256-bin으로 나누고 언어 모델이 순차적으로 7개 토큰을 생성한다. Loss는 다음 행동 토큰의 분류 cross-entropy이다. 1~99백분위 범위 밖의 값과 정밀 제어에서 양자화 오차가 발생할 수 있다.
P(a₁,…,a₇ | I,ℓ) - 05
5. 역토큰화하고 로봇에서 평가
토큰을 각 차원의 값으로 복구한 뒤 로봇 제어기에 전달한다. 영상·언어 해석과 실제 servo controller, robot-specific action normalization을 혼동하지 말자. 저자는 새 하드웨어에서 LoRA와 양자화 적응도 실험했다.
discrete bins → 7D action
PDF Figure 2 — DINOv2·SigLIP에서 7D 로봇 행동까지
방법론을 읽고 원본 Figure 2에서 카메라 입력→두 vision encoder→MLP→LLM→행동 역변환 화살표를 따라가자.
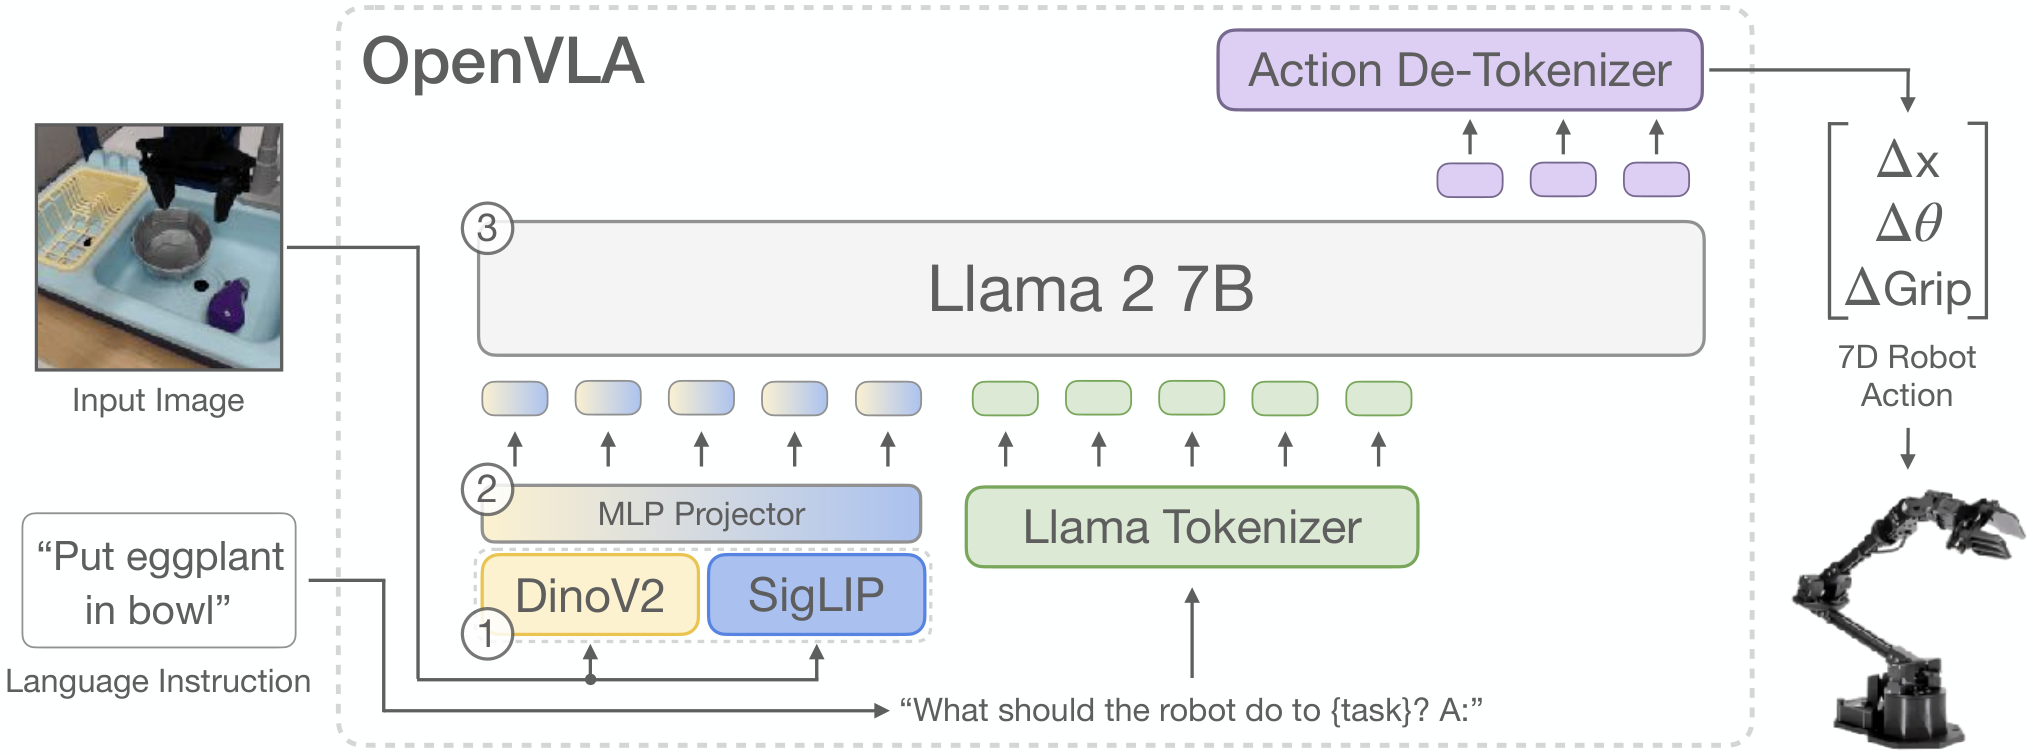
편집 캡션 요약 두 시각 백본 특징, projector, Llama 2, 7차원 action-token detokenizer의 연결.
- 01
카메라 이미지가 DINOv2와 SigLIP 두 인코더로 들어간다.
- 02
이어 붙인 visual feature를 MLP projector가 LLM 입력 공간으로 정렬한다.
- 03
Llama 2 7B가 7개 연속 행동 차원을 각각 256-bin token으로 예측한다.
- 04
역토큰화가 이산 출력을 7D 로봇 제어 명령으로 복원한다.
- 05
이 그림은 아키텍처다. 29과제 실험 성공률은 §5의 표에서 확인해야 한다.
한국어 해설은 이해를 돕기 위한 편집 해석이며 저자 논문에서 검증된 수치나 그림의 모든 패널을 대체하지 않습니다.
핵심 설계·학습 신호 해설
Figure 2를 왼쪽에서 오른쪽으로 읽기
영상 입력에서 DINOv2·SigLIP 두 줄을 찾고, 이 특징이 어떻게 합쳐져 MLP로 들어가는지 추적한다. 다음은 Llama 2가 action token을 출력하는 부분이다. 이 그림이 보여주는 것은 정보 흐름이지 새로운 로봇의 성공률 그래프가 아니다.
행동 토큰의 256-bin 양자화
현실의 Δx, Δy, Δz, 방향, 그리퍼 값은 연속 숫자지만, 모델은 사전에 정한 분할 구간으로 바꿔 학습한다. 공통 next-token 학습기법을 재사용하는 장점이 있는 반면, 미세한 접촉이나 집기 위치 보정에 오차가 생길 수 있다.
파인튜닝과 LoRA의 평가 범위
작은 로봇 데이터로 정책을 옮길 때 모델 전체를 갱신하지 않고 저랭크 행렬만 학습한다. 사용되는 비전 인코더, 로봇 입력, GPU 자원 및 평가 태스크가 메인 종합 평가와 달라질 수 있으므로, 성공률 수치만 따로 떼어 비교하면 안 된다.
실험과 주요 발견
약 970k 실물 로봇 시연을 포함한 Open X-Embodiment 혼합으로 학습했다. 직접 평가에서는 WidowX 17개 과제(방법당 총 170회)와 Google 로봇 12개 과제(방법당 60회)를 합친 29개 과제를 사용한다. 저자는 이 프로토콜에서 RT-2-X보다 평균 성공률이 16.5%p 높았다고 보고한다. 그러나 이 차이는 두 로봇에서 동일하게 발생하지 않으며 작업 종류별 차이가 있다. LoRA 적응 실험은 일부 조건에서 전체 파인튜닝과 비슷한 성능을 더 적은 학습 파라미터로 얻지만, 해당 효율 실험의 백본 설정을 원본 7B 종합 평가와 그대로 동일시할 수 없다. (§5, Appendix B–D)
실험 결과를 제대로 읽기
| 평가 항목 | 보고된 결과 | 해석 / 실험 조건 |
|---|---|---|
| 기본 학습 자료 | 약 970,000 real-robot demonstrations | Open X-Embodiment 정제 혼합, §3.3 |
| 실제 로봇 평가 규모 | 29 tasks · 230 rollouts / policy | WidowX 17×10와 Google Robot 12×5, §5.1 |
| RT-2-X 대비 차이 | +16.5 percentage points | 위 29-task 실험에서 보고한 성공률 차이, 로봇별 상세 결과 확인 |
| LoRA 효율 | 학습 파라미터 약 1.4% | 일부 Franka 파인튜닝 조건, 메인 7B 결과로 일반화 금지 |
ⓘ 성공률은 저자가 보고한 특정 프로토콜의 결과다. LoRA·양자화 효율 실험과 WidowX/Google 비교의 조건은 다르다.
한계와 비판적 검토
이산 256-bin 출력은 연속 행동의 세밀함을 잃을 수 있다. 로봇마다 카메라 위치, 좌표계 및 제어 주기가 달라 단순 가중치 복사만으로 동일한 성능을 보장하지 않는다. 29개 과제의 성공률도 실제 공장·가정·접촉 작업 전부를 대표하지 않는다. 특히 LoRA·양자화의 메모리 효율과 로봇 실환경 성공률은 별도 지표로 봐야 한다. 저자 실험을 독립 재현했다고 주장하지 않는다. (§5–6)
내 연구에 적용한다면?
아래는 논문 저자의 검증 결과가 아니라, 논문에서 출발해 설계한 **후속 실험 제안**입니다.
이산 action token 표현은 정밀한 접촉 제어에서 연속 행동 생성보다 성능 손실이 클 수 있다.
동일 로봇·동일 RGB/언어 지시·같은 시연 데이터로 tokenized OpenVLA 계열과 연속 행동 생성 계열을 미세조정한다.
256-bin / 128-bin / continuous output, 동일 encoder와 training budget 유지
task success, 접촉 error, latency, 자원 사용량, perturbation 이후 회복률
불균등한 데이터 크기나 action normalization 차이가 표현 방식의 효과를 가릴 수 있다.
원문을 읽으면서 확인할 4가지
- PDF Figure 2의 DINOv2·SigLIP → MLP → Llama 2 → 7D action 경로를 표시한다.
- §3.2에서 각 행동 차원의 256-bin 정규화와 1–99 percentile을 적는다.
- §5.1 WidowX 170회와 Google 로봇 60회의 평가 조건을 구별한다.
- §5.3 LoRA 실험의 백본 구성과 fine-tuning 대상 레이어를 적는다.
읽고 나서 남는 질문
- Figure 2의 dual vision encoder 중 하나를 제거하면 어떤 task family에서 가장 큰 성능 변화가 생기는가?
- 256-bin 행동 표현에서 작은 접촉 위치 보정이 희생되는가?
- 같은 로봇·동일 데이터를 고정한 상태에서 OpenVLA의 토큰 생성과 flow/diffusion 행동 생성 지연을 어떻게 비교할까?
- LoRA 실험에서 유지한 백본/시각 인코더 조건을 실제 적용 로봇과 맞추려면?
원문 / 출처 확인
편집자가 작성한 초록 기반 한국어 요약이며 공식 영문 초록의 원문/번역이 아닙니다.
원문 초록의 직역이 아니라 Method, 실험표 및 Figure를 바탕으로 작성한 한국어 기술 해설이다. 정량 결과는 저자의 보고이며, 재현 검증은 별도로 필요하다.
해설은 논문 저자들의 진술과 편집자의 비판적 질문을 구분합니다. 특정 지표·인과관계·재현성을 판단할 때는 반드시 원문의 실험 설정을 확인해 주세요.