▧ 원문 §III–V, Figure 2·3과 대조한 편집 해설 · 독립 재현은 별도 · 상세 연구 노트 포함 · 원논문 Figure 문맥별 해설
핵심을 먼저 읽기
‘무슨 단계까지 왔는가’를 기억할 희소 장기 프레임과 ‘지금 손끝에서 무슨 일이 일어나는가’를 예측할 조밀한 단기 프레임을 분리하되, action generation은 두 정보에 접근한다. 최종 로봇 행동을 생성할 때 고불확실성의 먼 미래 프레임을 직접 참고하지 않도록 attention을 제한하는 것이 핵심이다(§3).
왜 두 시간 척도인가? HiLo-WAM은 'future video를 얼마나 길게 뽑나'보다 '긴 미래의 불확실성이 정밀 제어를 망치지 않으면서 어떤 문맥을 제공할 수 있나'를 묻는다. §3의 asymmetric attention, §4의 ablation/temporal stride, Appendix A의 정확한 8·8·4 설정을 기준으로 읽는다. 시뮬레이션 성적과 실제 GR-3의 결과는 반드시 분리한다.
연구가 풀려는 문제
길고 복합적인 조작에서 로봇이 병을 계속 같은 상자에 넣어야 하는 상황을 떠올리면, 바로 앞 1초의 그리퍼 접촉만 봐서는 앞서 어떤 병을 선택했는지 잃을 수 있다. 반면 모든 장기 과정을 고프레임레이트로 생성하면 계산이 커지고 멀리 있는 미래 예측 오차가 행동을 오염시킨다. 기존 단일 시간 척도 WAM은 접촉 정밀도와 작업 전체의 순서를 동시에 만족시키기 어렵다. HiLo-WAM은 별도의 언어 플래너를 두는 대신 시각적 미래 예측 자체를 두 시간 해상도로 분리한다(§1–2).
핵심 아이디어
long-horizon stream은 과거 키프레임 8개와 희소 미래 프레임 8개를 stride k=4로 처리해 진척·목표 지속성을 포착한다. local stream은 32 프레임 규모의 근거리 시각 변화를 조밀하게 다룬다. Action DiT는 두 visual stream의 요약을 받아 연속 행동 chunk를 생성한다. 비유하자면 장기 stream은 ‘요리 전체 레시피의 단계 카드’, local stream은 ‘지금 칼끝과 재료의 순간 영상’이다. 서로 연결되지만 두 가지 해상도에 같은 계산을 할당하지 않는다(§3.2–3.3, Figure 2).
기존 연구와 무엇이 다른가?
Fast-WAM은 단기/local video 세계 모델과 행동 생성으로 강한 기준선을 제공하고, AHA-WAM은 장기 시각 문맥을 다루는 대조군이다. HiLo-WAM의 핵심은 장기 정보를 단순 추가하는 것보다 그 정보가 어떤 시점의 action에 접근할 수 있는지 제어한 비대칭 attention과 stream별 denoising 예산이다. π0.5와 같은 VLA가 명시적 소과제 언어를 생성하는 방식과 달리, 여기는 시각 세계 모델의 시간 해상도를 나눈다.
방법론 · 아키텍처
Wan2.2-5B 계열 비디오 VAE/Video DiT와 별도 Action DiT, T5 언어 인코더를 사용한다. 고해상도 시간축 로컬 비디오와 다운샘플된 장기 비디오를 동일 VAE로 별도 인코딩해 H/L 시각 토큰, 현재 상태 q, action 토큰 네 그룹을 구성한다. 비대칭 attention은 long-horizon 전 구간 내부 교환을 허용하지만, 로컬/행동 분기는 장기 과거와 가까운 미래에만 접근하고 먼 미래는 직접 읽지 않는다. 세 stream의 Flow Matching loss를 함께 최적화하며 λH=λL=λA=1을 사용한다. 추론은 action 10 step을 유지하면서 H/L은 각각 5 step에서 멈춰 cache, joint denoising와 유사 velocity의 dynamic skipping으로 비용을 낮춘다(§3, Appendix A).
모델 구조와 처리 흐름
개념적 처리 순서를 정리한 편집 다이어그램이며 원논문의 그림을 복제한 것은 아닙니다.
- 01
1. 로봇 현재 관측 및 언어 목표
각 t에서 RGB 이미지 oₜ, 14차원 로봇 상태 sₜ, 언어 지시 ℓ가 들어오며 14D action chunk를 예측한다. 개념적으로 필요한 관측은 작업 진행 과거와 손끝 상호작용 현재지만 두 정보를 동일 빈도로 샘플링할 필요는 없다.
(oₜ,sₜ,ℓ) → 두 시간 척도의 visual context - 02
2. 고수준 장기 시각 stream을 희소 샘플링
과거 m=8, 미래 n=8 키프레임을 stride k=4로 뽑는다. 장기 stream은 물체가 어느 단계까지 놓였는지, 목표가 앞으로 어떻게 변해야 하는지에 관한 coarse visual progression을 모델링한다. 생성 미래가 정확한 픽셀 정답이라는 가정이 아니다.
H stream: {oₜ₊ᵢₖ}, i=−8…8; k=4 - 03
3. 국소 시각 stream은 근거리 변화에 집중
현재와 가까운 32프레임을 밀도 높게 생성하도록 local stream을 만든다. 컵 손잡이 정렬, 블록 모서리 접촉처럼 작은 자세 변화가 중요하다. 두 비디오 시퀀스는 공통 pretrained VAE로 각각 인코딩한다.
L stream: dense VAE latents, T=32 - 04
4. 공유 Video DiT와 별도 Action DiT
Wan2.2-TI2V-5B로 초기화한 30-layer Video DiT가 두 시각 stream을, 30-layer Action DiT가 state/action token을 처리한다. 영상·행동은 modality별 파라미터를 유지하고 층별 joint attention으로 교환한다. T5가 양쪽에 언어 조건을 제공한다.
[Z_H, Z_L, q, Z_A] → structured MoT - 05
5. 비대칭 attention + 세 개의 flow loss
H 내부는 상호 참조하지만 L과 A가 직접 읽는 장기 정보는 historical context 및 가까운 미래(H_near)뿐이다; H_far는 고불확실성으로부터 action을 보호하기 위해 직접 차단한다. H/L/A의 미래 및 action latent에 독립적으로 flow time을 샘플링하고 동일 가중치 1의 loss를 합한다.
L= L_H + L_L + L_A; far-future direct access 차단 - 06
6. Progressive inference로 video 계산 멈추기
10회 denoising하는 action stream을 끝까지 실행하면서 H/L은 각각 5회만 계산 후 feature를 cache한다. 처음에는 동시 denoising, 후반에는 cached visual를 action이 재사용한다. 비슷한 velocity가 반복되는 단계는 cosine similarity 임계값에 따라 DiT eval을 건너뛴다.
n_H=5, n_L=5, n_A=10; partial→joint→skipping - 07
7. 두 종류의 시뮬레이션과 하나의 실물 설정에서 점검
RoboTwin 50 tasks는 각 clean/randomized 50 trials, RoboDojo 8 long tasks는 각 50 trials, 실물 GR-3는 Build/Disassemble House·Disassemble Heart 세 과제 각각 10 trials이다. progress와 strict success, 실물의 OOD 교란 범위를 분리해 기록한다.
simulation vs real, completion vs progress
Figure 2 — 두 시간 척도의 Video DiT와 Action DiT
원문 Figure 2는 sparse long-horizon historical/future visual, dense local dynamic visual와 액션 생성의 결합이다. 장기 정보가 작은 시간 오차로 당장 action에 전달되지 않도록 cross-stream attention이 제한된다.
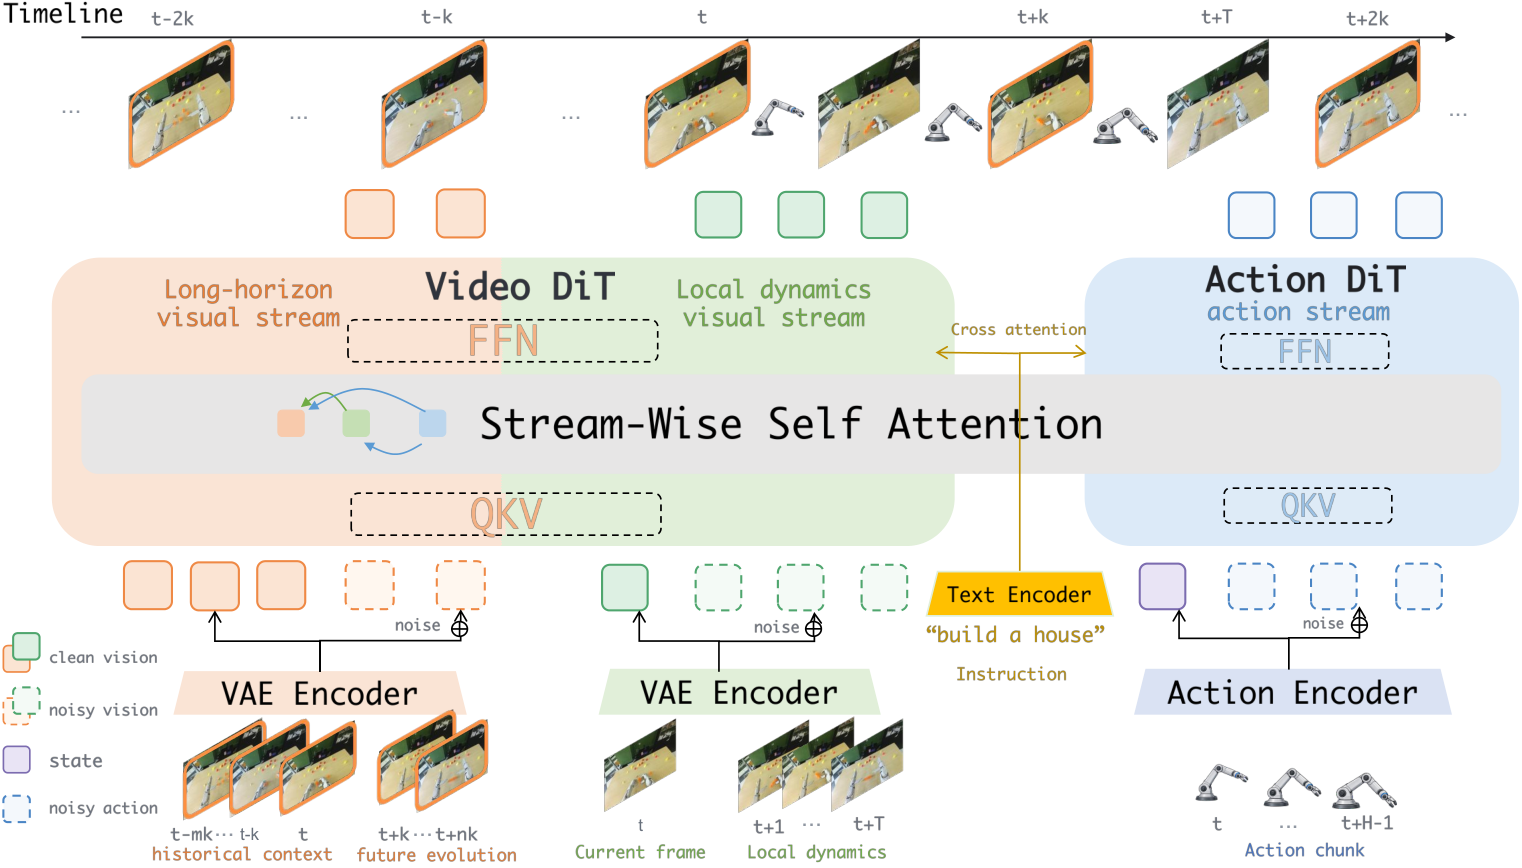
원문 캡션 일부 Figure 2: Architecture of HiLo-WAM. HiLo-WAM builds on a dual-DiT World Action Model consisting of a shared Video DiT and an Action…
- 01
상단 또는 좌측의 과거/미래 희소 프레임과 로컬 조밀 프레임을 구별한다.
- 02
공유 Video DiT와 모달리티별 Action DiT의 통로를 추적한다.
- 03
시각 5-step cache 이후 action이 남은 10-step denoising을 이어가는 경로를 찾는다.
- 04
원문 Figure 3에 상세한 H_far 차단 mask가 별도로 있다는 점을 확인한다.
한국어 해설은 이해를 돕기 위한 편집 해석이며 저자 논문에서 검증된 수치나 그림의 모든 패널을 대체하지 않습니다.
핵심 설계·학습 신호 해설
H_ctx·H_near·H_far를 구분하는 이유
§3.3 Figure 3의 mask에서 장기 stream에는 history/context와 near/far future가 있다. local/action이 H_far를 직접 읽을 수 있게 하면 부정확한 멀리 떨어진 예측이 당장의 손 위치 제어를 흔들 수 있다. 저자는 context와 near만 직접 참조하도록 제한했다.
Flow matching과 독립 time sampling
시각 두 줄과 action의 latent에 서로 다른 noise level을 부여하고, 각 stream의 velocity를 예측한다. 이 구조 덕분에 추론 중 H/L이 action보다 먼저 멈춰도 action의 이후 denoising이 진행될 수 있다. 각 lambda는 Appendix A 기준 모두 1.0이다.
성능 향상의 해석은 ablation 순서가 핵심
로컬-only 90.58→장기 미래 추가 93.22→장기 과거의 직접 attention 허용 93.70이다. local을 없애도 93.52로 소폭 낮아진다. 인과 주장은 이 특정 비교 조건에 제한하고, ‘장기 영상만 있으면 충분’이라고 해석하지 않는다.
장기 정보를 무조건 더 길게 보지 않는다
시각 token 수를 고정하고 stride k=1→4→8로 바꾸면 RoboTwin 성공률이 92.3→93.7→92.8%다. 지나치게 드문 샘플은 접촉과 단계 전환을 놓친다. 장기 범위와 시간 해상도 사이에 최적점이 있다는 결과다.
실물 Figure 4는 사례 시퀀스
Figure 4는 Fast-WAM이 병·블록 선택을 자주 바꾸거나 Mug Hanging에서 핸들을 잘못 정렬하는 모습을 대조한다. 하나의 이미지 시퀀스로 전체 성공률을 증명하지 않으며, 전체 로봇 집계는 §4.6 Figure 9의 ID/OOD 결과에서 확인해야 한다.
실험과 주요 발견
Table 1(a): RoboTwin 2.0의 clean 93.87%·randomized 93.52%·평균 93.70% 성공률(50 과제, 과제당 각 설정 50 trial). Fast-WAM 91.85%와 비교하면 +1.85%p. 그러나 장기 RoboDojo 8개 과제에서는 progress score 17.43와 strict success 6.50%를 기록했다(Table 1(b)); 93.70%를 ‘모든 장기 과제 성공률’로 오해하면 안 된다. Table 2의 로컬만 사용한 모델 90.58%, 장기 미래+로컬 93.22%, 전체 93.70%는 두 척도의 보완성을 보여준다. Table 3의 1회 action-chunk latency는 1114.46ms → 380.02ms(2.93×)이고, 실물 GR-3 세 과제의 평균 성공률은 ID 33%·OOD 30%(과제당 10 trial)이다(§4).
Figure 4 — 목표 변경 오류와 접촉 정렬 오류의 정성 비교
Fast-WAM은 일부 사례에서 목표 병이나 블록을 바꿔 잡거나 머그 손잡이 정렬에 실패하고, HiLo-WAM은 제시된 시퀀스에서 더 일관된 진행을 보인다. 이는 사례이고 전체 비율은 Table 1과 Figure 9의 별도 실험이다.
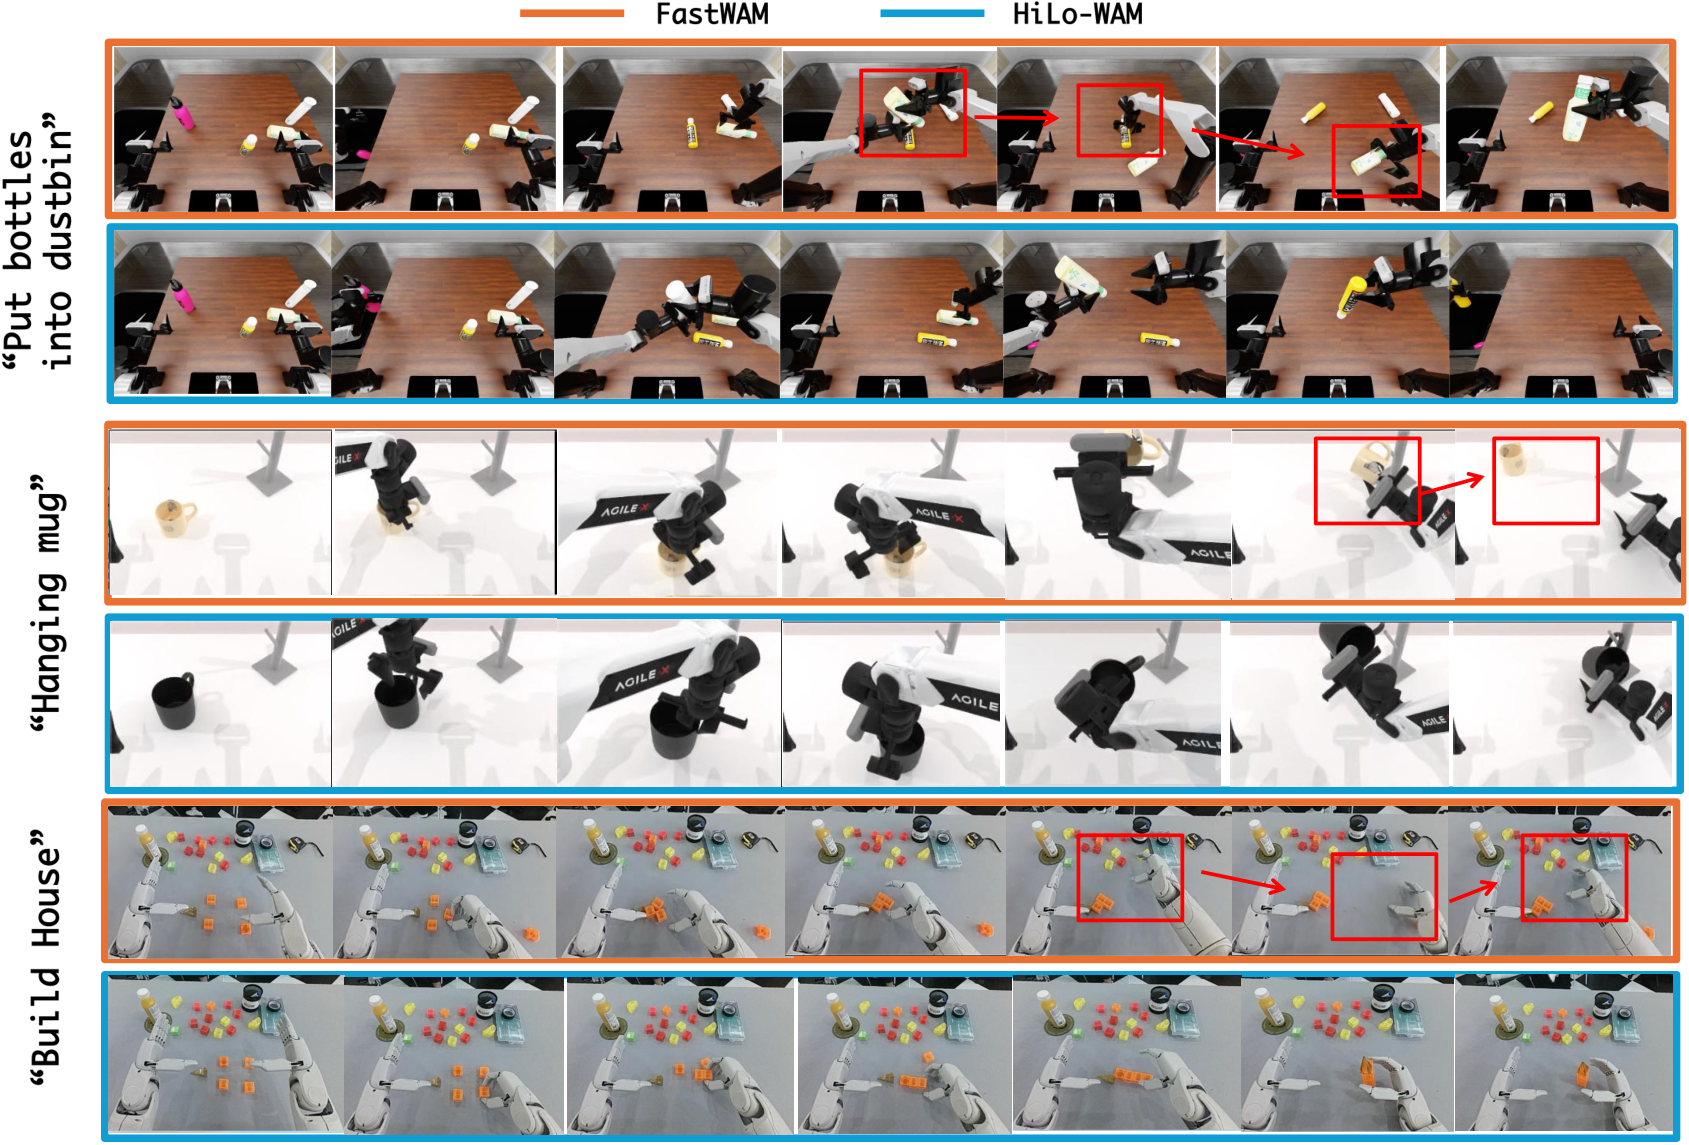
원문 캡션 일부 Figure 4: Qualitative comparison between Fast-WAM and HiLo-WAM in simulation and real-world tasks. Fast-WAM repeatedly changes its target bottle in Put Bottles…
- 01
Put Bottles into Dustbin 사례에서 여러 번 바뀌는 목표 대상을 찾는다.
- 02
Build House에서 쌓을 블록을 고수준으로 계속 기억하는지 확인한다.
- 03
Mug Hanging의 정밀 정렬은 장기 기억뿐 아니라 로컬 동역학이 필요하다는 증거로 읽는다.
- 04
실물 성공률 33%/30%의 분모는 3과제×10 trials인 §4.6을 별도로 확인한다.
한국어 해설은 이해를 돕기 위한 편집 해석이며 저자 논문에서 검증된 수치나 그림의 모든 패널을 대체하지 않습니다.
실험 결과를 제대로 읽기
| 평가 항목 | 보고된 결과 | 해석 / 실험 조건 |
|---|---|---|
| RoboTwin 2.0, 50 tasks | 93.87% clean / 93.52% randomized | Table 1(a): 각 과제/설정 50 trials, 평균 93.70% |
| RoboTwin Fast-WAM | 91.85% avg | Table 1(a): 91.90 clean /91.80 randomized; HiLo +1.85%p |
| RoboDojo 8 long-horizon tasks | Progress 17.43 / Success 6.50% | Table 1(b): 각 과제 50 trials; Fast-WAM 9.14/5.17% |
| Ablation: local-only | 90.58% | Table 2: long-horizon 둘 다 제거, RoboTwin |
| Ablation: long future + local | 93.22% | Table 2: 장기 과거 direct attention 꺼짐 |
| Ablation: full | 93.70% | Table 2: 장기 과거·미래 + local 모두 사용 |
| Temporal stride k=1 /4 /8 | 92.3% / 93.7% / 92.8% | §4.4, 같은 visual-token budget |
| Action chunk 지연 | 1114.46→380.02 ms (2.93×) | Table 3: RTX PRO 5000 단일 GPU, prompt embedding 캐싱 |
| 실물 GR-3 | ID 33% / OOD 30% strict success | §4.6 Figure 9: 세 과제×10 trials, progress 6.9/6.0 |
ⓘ RoboTwin의 93.70%는 50개 시뮬레이션 과제 평균이고, RoboDojo의 6.50%는 다른 8개 장기 과제의 엄격한 성공률이다. 실물의 33%/30% 또한 30개 시도 수준의 작은 표본이다. RTX PRO 5000 지연은 언어 임베딩 캐싱 이후의 추론 호출로 end-to-end 로봇 제어 시간이 아니다.
한계와 비판적 검토
기반 비디오 모델이 잘못 이해하는 복잡한 계획·명시적 소과제 분해는 이 구조만으로 해결하지 못한다(§5). RoboTwin의 높은 숫자는 광범위한 현실 성공률을 뜻하지 않으며 RoboDojo에서 strict success는 6.5%로 여전히 낮다. 실물 실험도 한 종류의 Fourier GR-3와 세 작업, 조건당 10회의 작은 표본이다. 도메인 랜덤화는 명시된 시각/물리 교란일 뿐 임의 현장 전체를 포함하지 않는다. 단일 GPU에서 측정한 추론 지연과 실제 제어 시스템 end-to-end latency 역시 구분해야 한다.
내 연구에 적용한다면?
아래는 논문 저자의 검증 결과가 아니라, 논문에서 출발해 설계한 **후속 실험 제안**입니다.
과거 장기 목표 지속성과 근거리 접촉 정보를 분리하되 H_far의 직접 attention을 차단하면 장기 시퀀스에서 목표 전환 오류와 정밀 조작 오류를 동시에 줄인다.
RoboTwin 2.0의 동일 50 tasks/동일 50+500 demos 프로토콜로 H_ctx/H_near/H_far mask, local-only, k=1/4/8을 통제하고 GPU별 latency를 기록한다. 가능하면 실물 GR-3 외의 platform에서 10회보다 더 많은 episode를 실행한다.
Fast-WAM, long-only, local-only, full mask, H_far unmasked, n_H/n_L 5/10 steps
task strict success per task, milestone progress, target-switch rate, contact alignment error, rollout length, action-chunk wall time, 실패후 복구
사용된 pretrained video backbone·데이터 mixture 차이, 물리 실험의 장비 안전과 소표본, long context에서 episode leakage를 통제해야 한다.
원문을 읽으면서 확인할 4가지
- Figure 2에서 H/L 입력과 Video DiT·Action DiT 경로를 따라가고 Figure 3의 H_far 차단 규칙을 찾아본다.
- Appendix Table 4에서 (m,n,k,T,H)=(8,8,4,32,32)와 (n_H,n_L,n_A)=(5,5,10)을 표시한다.
- Table 1(a)의 RoboTwin 성공률과 Table 1(b)의 RoboDojo progress/strict success를 별도 메모한다.
- Table 2는 long-history, long-future, local 세 항을 각각 제거한 ablation임을 표시한다.
- Table 3의 GPU·캐싱·denoising 조건을 확인한 후 2.93×의 의미를 해석한다.
- Figure 4의 사례 실패와 §4.6 Figure 9 실물 집계를 구분한다.
읽고 나서 남는 질문
- Figure 2에서 어떤 high-future 토큰이 action으로 전달되지 않는지 attention mask로 표시할 수 있는가?
- Table 2의 90.58→93.22→93.70 차이가 모델 크기·훈련 데이터량이 아닌 시각 척도 변경에서 왔음을 어떻게 확인하는가?
- RoboTwin 93.70%와 RoboDojo success 6.50% 사이의 평가 목표·과제 길이 차이는 무엇인가?
- GR-3에서 눈에 가려진 블록을 다루는 중 장기 memory가 오히려 틀린 목표를 유지하면 어떤 reset이 필요한가?
원문 / 출처 확인
편집자가 작성한 초록 기반 한국어 요약이며 공식 영문 초록의 원문/번역이 아닙니다.
World Action Model을 두 시간 축의 시각 생성으로 나누어 조작 성능·처리 지연을 함께 개선하려는 연구. 제시한 성공률은 각기 다른 시뮬레이션/실물 테스트를 혼합한 수치가 아닌 원문별 조건을 따로 기록한다.
해설은 논문 저자들의 진술과 편집자의 비판적 질문을 구분합니다. 특정 지표·인과관계·재현성을 판단할 때는 반드시 원문의 실험 설정을 확인해 주세요.