▧ 원문 §III–V, Figure 2·3과 대조한 편집 해설 · 독립 재현은 별도 · 상세 연구 노트 포함 · 원논문 Figure 문맥별 해설
핵심을 먼저 읽기
행동 토큰 지도 없이 expert의 gradient까지 끊으면 VLM은 연속 행동 예측에 필요한 표현을 배울 직접 신호가 약해진다. 반대로 FAST/이산 행동 CE가 있으면 open-loop에선 insulation도 경쟁력 있으나, closed-loop에서는 coupling의 장점이 다시 나타난다(§3–4).
연구 질문: VLA에서 VLM의 행동 이해를 강화하는 길은 ‘이산 행동 토큰을 직접 예측시키는 CE’와 ‘연속 행동 expert의 오차를 역전파시키는 coupling’ 두 가지다. 본 해설은 논문 §3의 2×2 설계, §4의 주행·조작 실험, Appendix A/C의 입력과 지표 정의를 함께 읽는다. route progress·normalized task progress는 strict success rate와 다르다.
연구가 풀려는 문제
카메라와 언어를 읽는 VLM은 개체·상황 이해에 강하지만, 미래 6.4초를 정밀 제어하는 학습목표로 사전학습된 것은 아니다. Mixture-of-Transformers VLA에서는 VLM이 생성하는 layerwise K/V를 Flow Matching Action Expert가 소비한다. 실무에서는 성능 향상을 위해 expert loss가 VLM을 바꾸게 해야 할지, 언어·시각 능력의 손상을 피하려 stop-gradient로 차단해야 할지 결정해야 한다. 기존 레시피는 stop-gradient와 discrete action-token CE를 함께 쓰는 경우가 많아 각 원인의 기여를 혼동했다(§1–2).
핵심 아이디어
두 축만 독립적으로 바꾼다. 첫 축은 미래 행동을 이산 토큰으로 예측하는 CE를 켜거나 끄는 것, 두 번째는 expert의 연속 행동 Flow Matching loss가 K/V cache를 거쳐 VLM까지 역전파되는 coupling인지, 같은 cache의 역방향만 막는 insulation인지다. 네 조건은 forward 입력과 expert 구조를 동일하게 유지한다. 비유하면 VLM에 ‘운전 경로 답안’을 따로 채점할지(action CE), 실제 조향을 수행하는 expert의 오차를 VLM에게 피드백할지(coupling)를 분리해 보는 실험이다. 둘은 일부 대체 가능하지만 완전히 같지 않다(§3, Figure 1).
기존 연구와 무엇이 다른가?
π0.5나 MolmoAct2의 계열 설계가 action-token supervision과 expert gradient routing을 함께 선택할 때 왜 성능 해석이 복잡해지는지 분리해 준 논문이다. 이 연구는 새로운 더 큰 VLA backbone을 제안하는 모델 논문이라기보다 학습 신호의 통제 실험이다. OpenVLA(2406.09246)의 이산 다음 토큰 정책과 π0(2410.24164)의 연속 행동 expert를 단순 비교하는 것도 금물이다: 모델·로봇·지표가 모두 다르기 때문이다.
방법론 · 아키텍처
주행 구현의 VLM은 Qwen3-VL-2B-Instruct, expert는 non-causal flow-matching transformer다. 6.4초·10 Hz 미래를 64개의 가속도/곡률 쌍으로 출력하고 unicycle dynamics로 궤적을 복원한다. VLM은 주행 설명·경계 토큰을 예측하며, action CE 활성 조건에서는 같은 미래 제어의 128개 이산 value-token에도 CE를 받는다. 추론에서는 미래 value-token을 생성하지 않고 시작 토큰까지만 디코딩한 뒤 expert가 cache를 읽고 10회 Euler 적분으로 연속 행동을 만든다. Loss는 CE와 flow 각 가중치 1; insulation에서는 K/V를 detach한다. 동시 학습 300k와 VLM-first·Expert-first 100k+200k 총 세 순서를 비교한다(§3, Appendix A.1–A.2).
모델 구조와 처리 흐름
개념적 처리 순서를 정리한 편집 다이어그램이며 원논문의 그림을 복제한 것은 아닙니다.
- 01
1. 시각/언어·주행 이력으로 VLM 표현 형성
주행에서는 4개 RGB 카메라와 과거 ego 궤적 토큰, 도로 상황에 관한 언어 정보가 Qwen3-VL-2B-Instruct로 들어간다. reasoning이 있을 때 관련 객체와 예정 대응을 설명한 뒤 future_start 경계 토큰을 낸다. 시각 backbone과 언어 추론은 모든 2×2 조건에서 동일하다.
입력: RGB·past ego history·instruction → layerwise K/V - 02
2. action-token CE 스위치
미래 64개의 (acceleration, curvature) 쌍을 이산화해 128개 value-token CE를 ON/OFF한다. OFF도 teacher-forced input은 남겨 놓되 그 위치의 CE target을 mask하고, CE 분모는 mask 전 개수로 고정해 다른 CE 항의 상대 크기를 부풀리지 않는다. expert cache는 future_start 뒤 미래 값을 읽지 못하게 자른다.
Action CE ∈ {ON,OFF}; 일반 VQA·reasoning CE는 항상 유지 - 03
3. 별도의 Flow Matching Expert
VLM의 layer별 K/V를 조건으로 Action Expert가 가우시안 노이즈에서 연속 제어를 복원한다. 목표는 a−ε velocity, 보간 경로는 aₜ = t·a+(1−t)·ε다. 학습에서는 action-bearing 배치에서 expert loss를 계산하고, 주행 추론은 10회 Euler step을 사용한다.
L_flow(a, K/V) → 64 continuous controls → unicycle waypoints - 04
4. K/V 역전파 경로만 바꾼다
Coupled 조건은 expert loss의 gradient가 K/V를 통해 VLM과 expert 양쪽에 전파된다. Insulated는 같은 forward K/V에 stop-gradient를 걸어 expert만 해당 loss로 갱신된다. 따라서 action CE ON/OFF와 routing ON/OFF를 조합한 네 cell이 생긴다.
2×2 = {CE ON/OFF} × {coupled/insulated} - 05
5. 학습 순서 3종을 통제한다
Concurrent는 처음부터 VLM과 expert를 같이 300k step 학습한다. Expert-first는 VLM을 동결한 채 expert만 100k, 이어서 공동 200k; VLM-first는 expert 없이 VLM 100k, 이어서 공동 200k다. 공동학습에서 궤적 배치 확률 48.5%, 그 밖의 vision-language 배치 약 51.5%.
Total steps 300k; 학습 history 자체가 별도 실험 축 - 06
6. 오프라인 정확도와 실제 상호작용 지표를 분리한다
Open-loop는 6개 궤적 중 첫 후보의 ADE와 oracle minADE를 구분하고, closed-loop은 AlpaSim에서 route progress를 잰다. 로봇 조작은 PolaRiS BlockStackKitchen·FoodBussing·PanClean에서 50회씩 실행하고 진척 rubric을 평가한다.
주행 오차 ADE ≠ 주행 progress ≠ 조작 success
Figure 1 — Action-token CE와 expert gradient의 두 신호
저자 Figure 1의 왼편은 VLM K/V→expert 연결과 CE gradient 경로를 보여주고, 오른편은 두 스위치에 따른 open-loop 학습 오차를 보여준다. CE가 ON인 경우 routing 차이가 작다고 모든 closed-loop 차이도 작다는 뜻은 아니다.
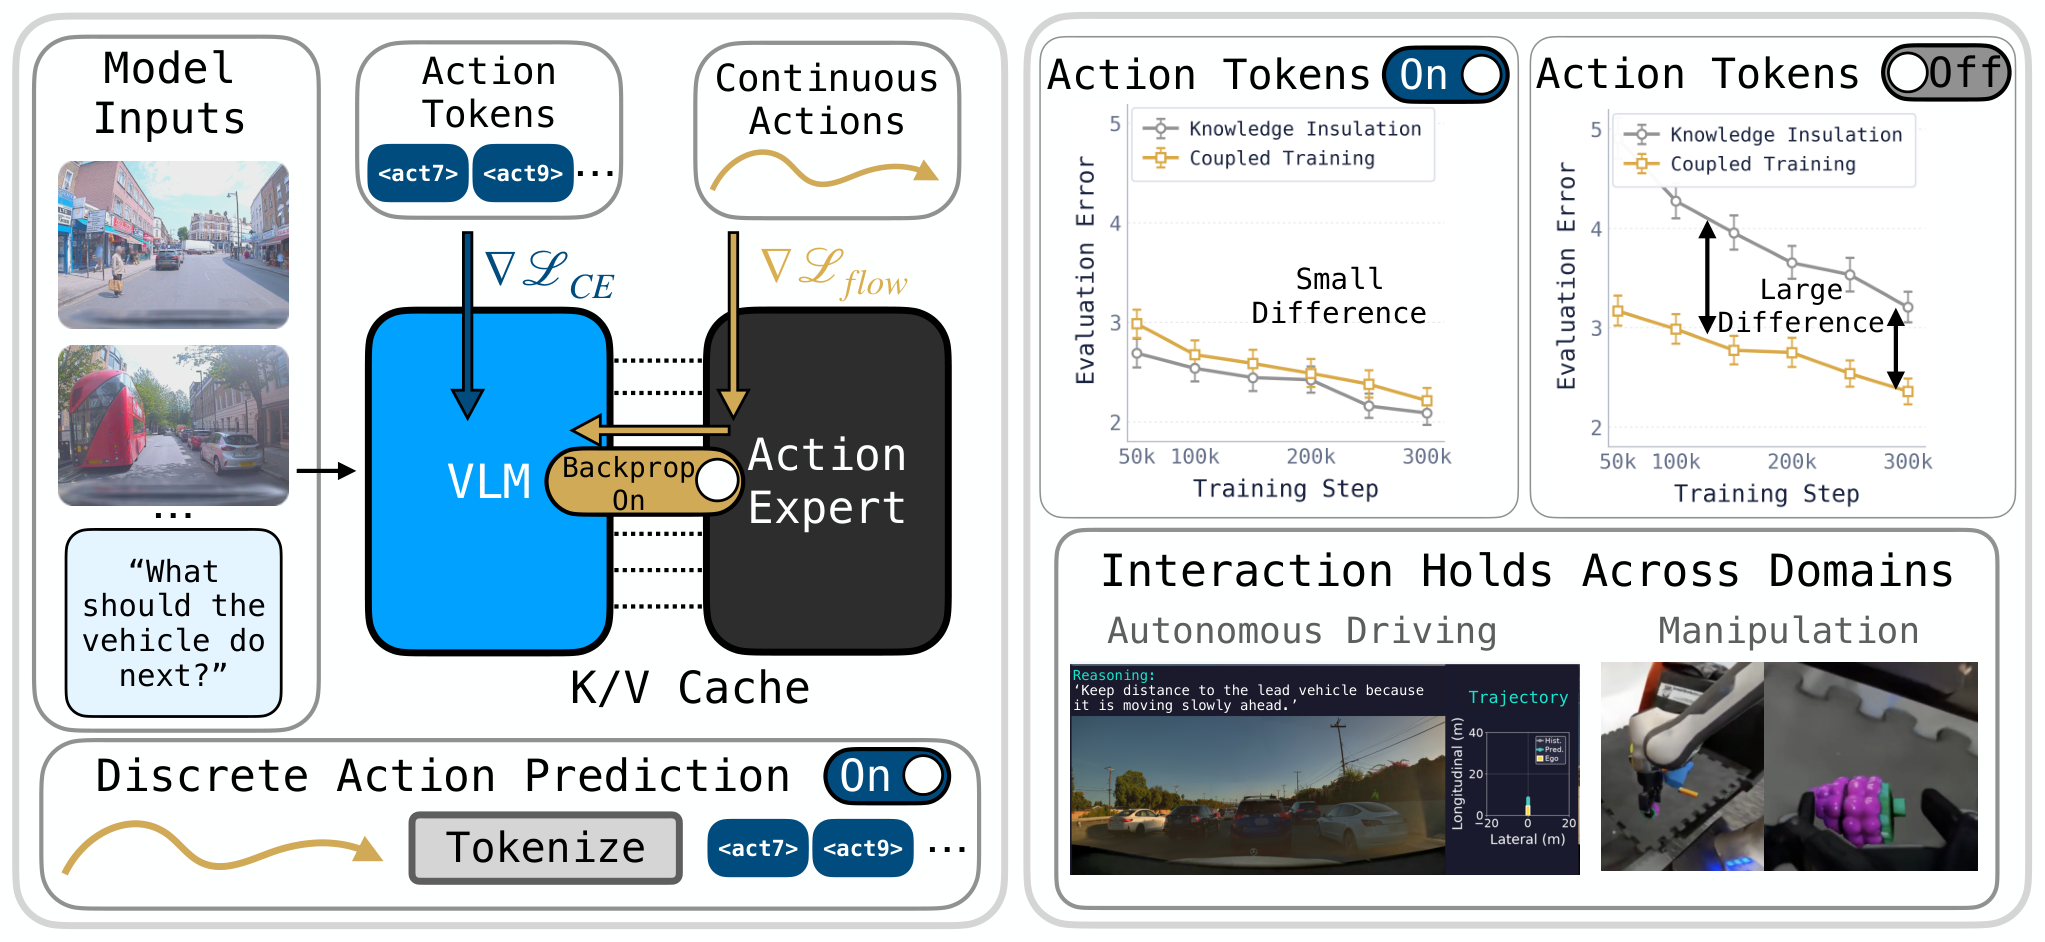
원문 캡션 일부 Figure 1: Action-token supervision shapes the effect of expert-to-VLM gradient flow. Left: the VLM is supervised to predict discrete action tokens while…
- 01
왼쪽 VLM의 token supervision 화살표와 연속 expert loss 역전파 경로를 구분한다.
- 02
Insulation의 forward K/V는 동일하며 역전파만 막힌다는 사실을 확인한다.
- 03
오른쪽 곡선은 open-loop 오류이지 AlpaSim의 실제 progress 수치가 아니다.
- 04
CE ON/OFF의 색상 또는 구분을 Table 3 closed-loop 수치와 연결하되 지표는 혼동하지 않는다.
한국어 해설은 이해를 돕기 위한 편집 해석이며 저자 논문에서 검증된 수치나 그림의 모든 패널을 대체하지 않습니다.
핵심 설계·학습 신호 해설
경계 토큰 이후의 미래 정답 누수 방지
Appendix A.1은 expert-facing K/V를 future_start에서 절단한다. 미래 128개 value-token의 teacher-forced input은 학습 CE 계산에 남아 있어도 expert가 그 hidden states를 바로 소비할 수 없다. 이 조치가 없다면 gradient routing 효과가 정답 누수와 섞일 수 있다.
2×2의 물리적 의미
action CE를 켜면 VLM이 실제로 미래 제어를 맞히도록 직접 학습된다. coupling을 켜면 연속 제어 재구성에 필요한 정보가 K/V에 반영될 수 있다. action CE가 OFF인 insulated 모델은 직접적인 미래 행동 지도 두 갈래가 모두 없어서 open-loop의 손실이 클 수 있다. 이것은 관측된 경향에 대한 해석이지 인과 메커니즘의 증명은 아니다.
Open-loop와 closed-loop의 최적화 목표 불일치
Ground truth와 64-step waypoint 거리인 ADE가 낮아도 상호작용에서 주행 진척·충돌 비율이 최적이진 않을 수 있다. Table 3은 coupled + CE ON이 가장 높은 concurrent progress 0.703을 보이지만, Appendix는 일부 staged 조건에서 at-fault collision 불이익을 지적한다.
로봇 조작 평가에서의 조건 보존
π0.5 재구현은 PaliGemma-3B+expert, 400k step, robot 데이터 DROID 90%/PolaRiS 10%, VQA 절반을 사용한다. MolmoAct2는 별도 백본과 300k 공동학습+1k adaptation이다. 동일 가족 안에서 4조건을 비교해야 하며 π0.5와 MolmoAct2 사이 절대 점수 비교는 통제 실험이 아니다.
실험과 주요 발견
Table 3의 AlpaSim 동일 827개 scene·scene당 확률적 rollout 5회 기준, concurrent 학습에서 route progress는 action tokens ON일 때 insulation 0.600 → coupling 0.703, OFF일 때 0.425 → 0.601이다. open-loop Physical AI Autonomous Vehicles Public Golden 1,434개·OOD 273개에서는 tokens ON인 경우 routing 차이가 작지만 OFF이면 coupling이 mean ADE를 약 26%/24% 낮췄다(§4.1, Figure 3). PolaRiS 세 조작 태스크의 equal-weight normalized task progress(Table 4)에서도 π0.5 재구현의 FAST OFF는 insulation 10.3%/coupling 32.9%, MolmoAct2는 14.5%/36.5%다. 이 값은 과제 성공률이 아니라 달성한 rubric 비율이다. Figure 4는 대표적 실행을 보여줄 뿐 세 과제의 평균을 대신하지 않는다.
Figure 4 — 세 장면 시퀀스가 설명하는 것과 못 하는 것
Figure 4의 PanClean·MoveLatteCup·BlockStackKitchen은 제시된 대표적인 simulation rollout이다. MoveLatteCup은 정성 사례에만 포함되며, Table 4의 평균은 BlockStackKitchen·FoodBussing·PanClean 세 과제다.
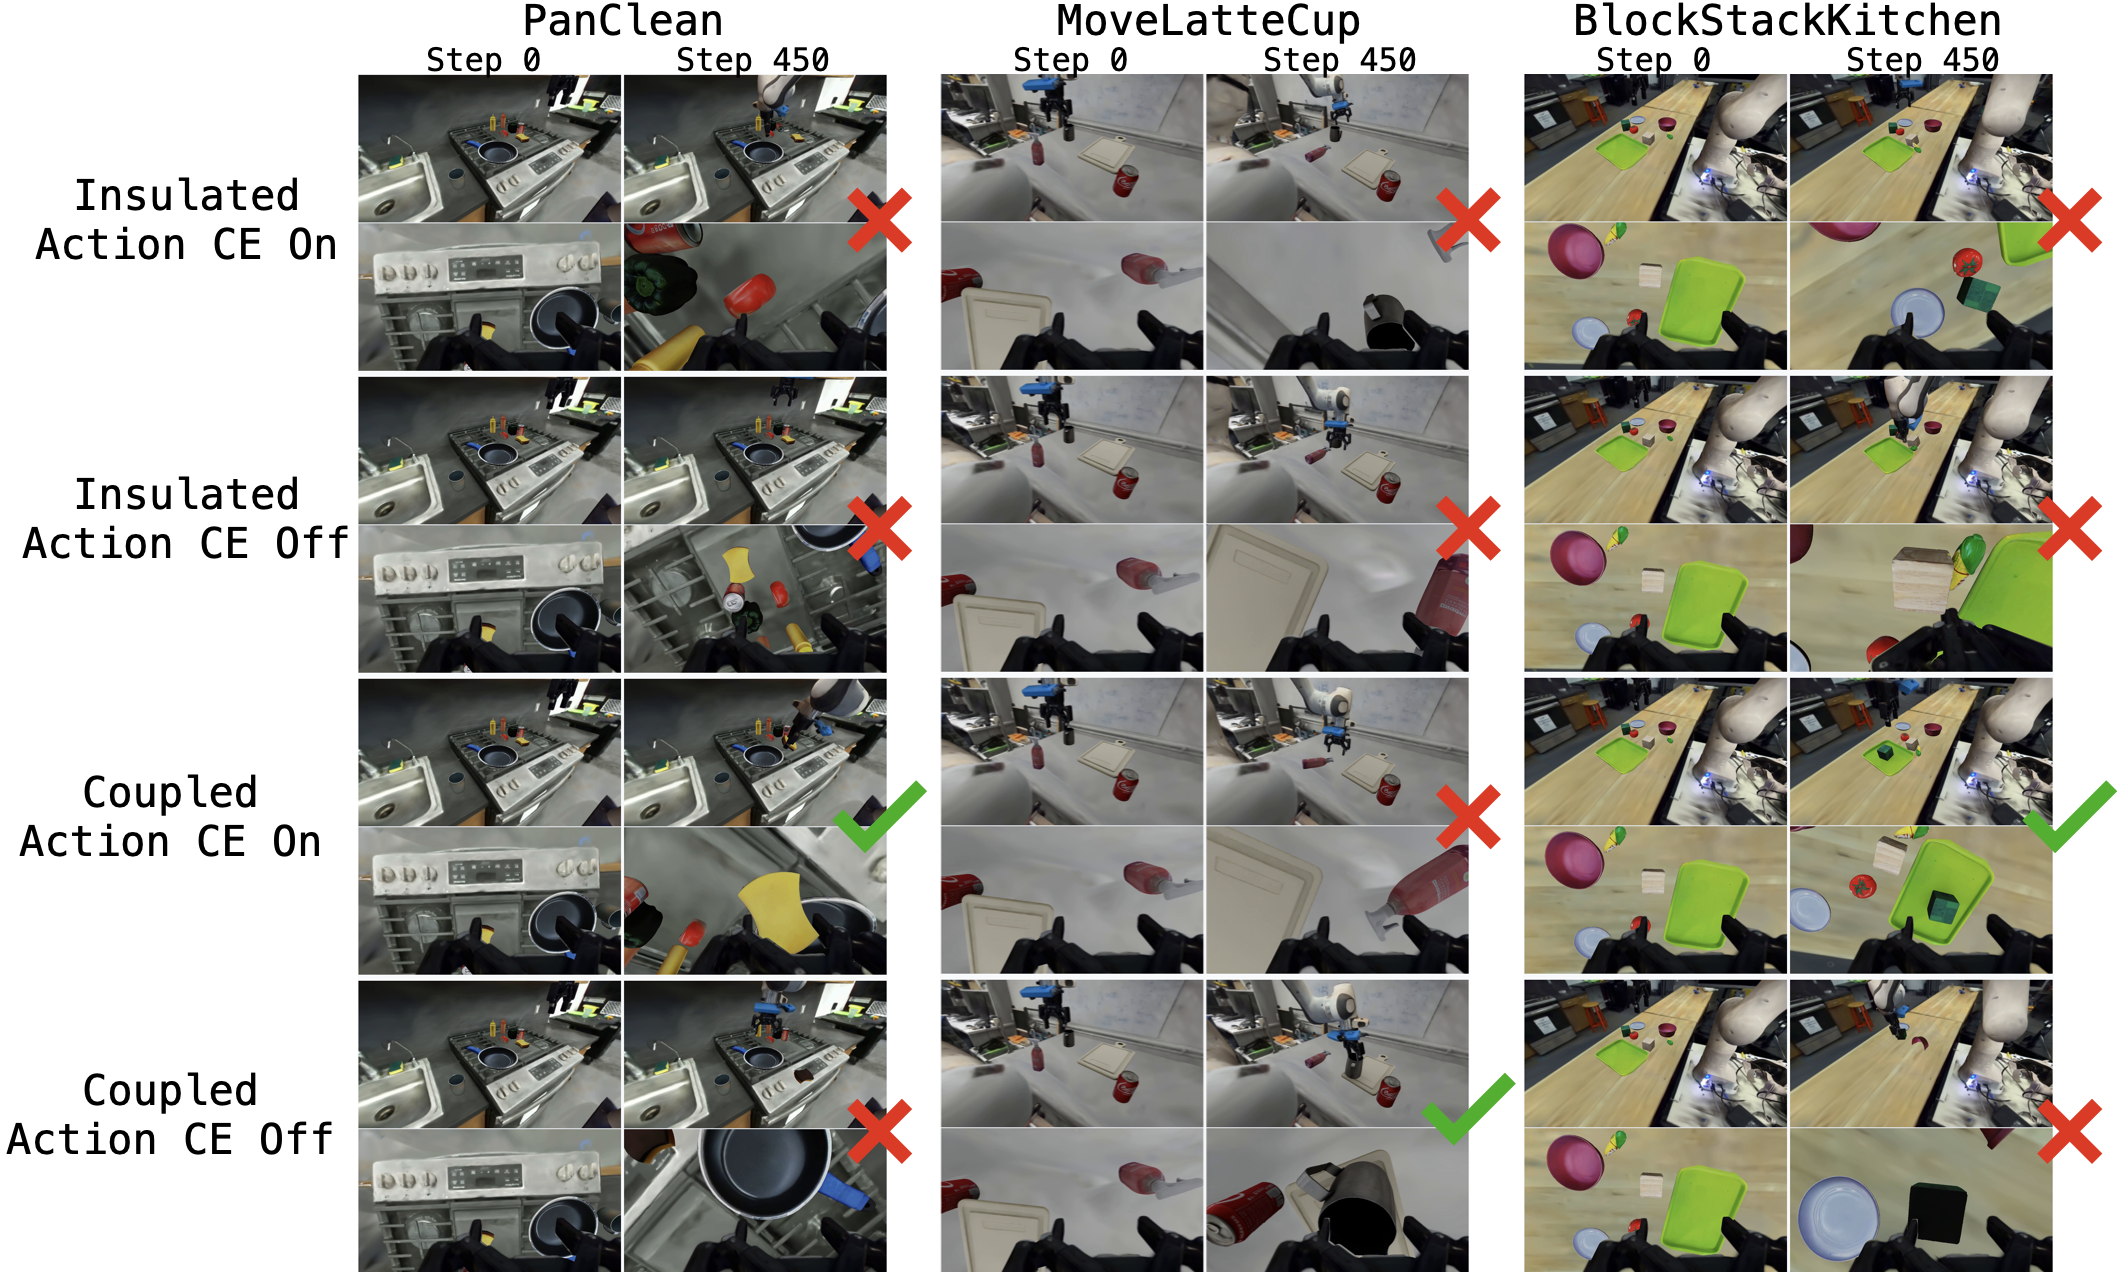
원문 캡션 일부 Figure 4: Closed-loop manipulation examples. Rollouts of the four concurrently trained policies in PanClean (left), MoveLatteCup (center), and BlockStackKitchen (right). MoveLatteCup is…
- 01
행별로 coupled와 insulated 실행이 실제로 다른 부분을 비교한다.
- 02
표시된 check mark를 전체 세 과제의 성공률로 바꾸어 읽지 않는다.
- 03
MoveLatteCup이 Table 4의 세 과제 평균에서 제외됨을 기록한다.
- 04
표의 %는 normalized rubric progress로 450-step episode의 strict success가 아니다.
한국어 해설은 이해를 돕기 위한 편집 해석이며 저자 논문에서 검증된 수치나 그림의 모든 패널을 대체하지 않습니다.
실험 결과를 제대로 읽기
| 평가 항목 | 보고된 결과 | 해석 / 실험 조건 |
|---|---|---|
| Concurrent AlpaSim · CE ON | Insulated 0.600 → Coupled 0.703 | Table 3. 같은 827 scene×5 rollout; route progress, 높을수록 좋음 |
| Concurrent AlpaSim · CE OFF | Insulated 0.425 → Coupled 0.601 | Table 3. +0.176 절대 상승(약 41% 상대); 성공률 아님 |
| Open-loop driving · CE OFF | ADE 약 26% ↓ Public Golden / 24% ↓ OOD | §4.1. coupling vs insulation, 1,434/273 사례; 첫 후보 ADE |
| Reasoning 품질 · CE ON | Lingo-Judge pass 64.7% vs 64.9% | Table 2. Public Golden first-sample, insulated/coupled; 전체 VLM 보존 지표 아님 |
| π0.5 재구현 · FAST ON | 19.5% → 30.7% | Table 4. PolaRiS 3과제 mean normalized task progress, insulation→coupling |
| π0.5 재구현 · FAST OFF | 10.3% → 32.9% | Table 4. 같은 가족의 2×2 실험; 독립 pretrained π0.5의 40.0%와 비교 금지 |
| MolmoAct2 · FAST OFF | 14.5% → 36.5% | Table 4. 300k+1k adaptation; 세 과제 50회씩 |
| 훈련·추론 설정 | 300k steps / 10 Euler / 64 controls | Appendix A.1–A.2. 6.4초·10 Hz acceleration/curvature |
ⓘ Table 3의 숫자는 0~1 척도의 route progress, Table 4의 %는 달성한 조건 수를 정규화한 task progress다. 둘 모두 원칙적으로 strict task success rate가 아니다. bootstrap 95% CI는 training seed 다변성을 포함하지 않는다.
한계와 비판적 검토
단일 training seed, 운전과 조작 모두 closed-loop 평가는 시뮬레이터, 실물 로봇 결과 없음. 운전에서 95% bootstrap CI는 특정 checkpoint의 clip sampling 불확실성이지 다른 학습 seed의 분산이 아니다. 행동 토큰을 끄면 VLM-first warm-up 입력 데이터 분포도 일부 바뀌므로 학습순서 간 비교에 예산 차이를 주의해야 한다. Driving rationale용 Lingo-Judge 점수가 전반적인 시각·언어 사전학습 능력 보존을 증명하지도 않는다. π0.5 공개 모델의 40.0% progress는 다른 훈련 데이터 및 평가 프로토콜이므로 이 논문의 19.5%와 통제된 apples-to-apples 비교가 아니다(§5, Appendix A/C).
내 연구에 적용한다면?
아래는 논문 저자의 검증 결과가 아니라, 논문에서 출발해 설계한 **후속 실험 제안**입니다.
Action-token CE가 없을 때 coupled routing은 같은 VLM 표현에 더 직접적인 행동 정보를 주지만, 기능 보존과 안전의 trade-off는 별도로 존재한다.
동일 Qwen3-VL checkpoint·동일 VQA/trajectory mixture·고정 주행 카메라와 300k step을 준비하고 CE ON/OFF×detach ON/OFF 네 조건을 최소 3 seed 반복한다. 필요하면 동일 요소를 실물 양팔 로봇 한 플랫폼에 이전한다.
4개 2×2 cell + frozen VLM + VLM-first warm-up 비교, token target만 바꾸고 expert/배치·계산량은 고정
first-sample ADE, oracle minADE, route progress, at-fault collision, language/VQA retention, manipulation strict success 및 normalized progress, seed별 CI
물리 로봇 배치는 충돌 방지/비상정지 필요. Warm-up에서 tokens-OFF 데이터 비중 차이, seed 1회, 평가 rubric이 실질 성공을 과대평가할 가능성을 통제해야 한다.
원문을 읽으면서 확인할 4가지
- 공식 HTML Figure 1에서 CE 스위치와 expert-to-VLM gradient 경로를 각각 표시한다.
- §3 식(1)–(2) 및 Appendix A.1 Eq.(3)에서 mask 전 고정 CE 분모와 cache cutoff를 확인한다.
- Table 3에서 Concurrent/VLM-first/Expert-first 행을 분리해 route progress와 열린 주행 ADE를 비교한다.
- Table 4에서 4개 factorial 조건과 마지막 참고 checkpoint를 구분하고 progress 정의(Appendix C)를 적는다.
- Figure 4의 MoveLatteCup은 정성 사례일 뿐 평균의 세 과제 중 하나가 아님을 명시한다.
- Appendix 안전 결과의 at-fault collision까지 읽어 progress만으로 좋은 주행 정책이라 단정하지 않는다.
읽고 나서 남는 질문
- Figure 1에서 action CE의 직접 지도와 expert gradient는 VLM의 어떤 계층의 K/V 표현을 바꾸는가?
- Table 3의 route progress 증가와 Appendix의 at-fault collision 변화가 충돌할 때 어떤 정책을 선택해야 하는가?
- Figure 4에 등장하는 MoveLatteCup이 왜 세 과제 평균에는 포함되지 않는가?
- 작업 진행(progress)이 아닌 strict task completion과 실제 로봇의 안전 지표에서도 효과가 유지되는가?
원문 / 출처 확인
편집자가 작성한 초록 기반 한국어 요약이며 공식 영문 초록의 원문/번역이 아닙니다.
원논문의 초록 번역을 넘어, 동일 아키텍처에서 VLM에 들어가는 행동 학습 신호 두 개를 분리한 대조 실험을 해설한다. 수치는 논문 저자 측의 관측이며 로봇 실물 검증을 뜻하지 않는다.
해설은 논문 저자들의 진술과 편집자의 비판적 질문을 구분합니다. 특정 지표·인과관계·재현성을 판단할 때는 반드시 원문의 실험 설정을 확인해 주세요.