▧ 원문 §III–V, Figure 2·3과 대조한 편집 해설 · 독립 재현은 별도 · 상세 연구 노트 포함 · 원논문 Figure 문맥별 해설
핵심을 먼저 읽기
비디오 생성 가중치로부터 얻은 사전지식은 유지하되, 새 학습 목표는 RGB 미래 장면 대신 3D 물체 운동을 예측한다. 실물 OOD에서 scene-flow+action(MA) 18/30, video+action(VA) 2/30이라는 차이가 이 연구의 주장을 지탱한다(Table I).
이 글의 핵심 실험 통제: ‘비디오 사전학습의 이점’과 ‘미래 비디오 자체를 예측해야 하는가’는 다른 질문이다. 동일 Wan2.2 백본의 MA(3D motion+action), VA(video+action), VMA(video+motion+action)를 비교하고, Table I의 SR/TP 및 반복 수, Appendix A·B의 데이터와 비용까지 함께 읽는다.
연구가 풀려는 문제
사람이 서랍을 여닫는 영상은 로봇 행동 레이블 없이 풍부하게 얻지만, 그대로 미래 RGB 프레임을 예측하면 질감·조명·배경까지 재현해야 한다. 로봇에게 중요한 것은 ‘문손잡이가 4cm 이동했다’는 기하학적 변화이지 문짝의 무늬가 아니다. 2D optical flow는 카메라 자체 이동과 객체 운동을 뒤섞을 수 있고, action-free 인간 영상은 로봇 모터 명령과 1:1로 대응되지 않는다. 기존 video-action WAM이나 2D track 기반 접근이 새 물체·동작으로 넘어갈 때 강인한지 검증이 필요하다(§I–II).
핵심 아이디어
FloMo는 최초 카메라 좌표계에 정렬된 누적 3D scene flow를 미래 행동의 중간 표현으로 삼는다. 16프레임 창의 4,096개 3D 점이 첫 장면 대비 얼마나 이동했는지 추적한 뒤 각 축의 이동량을 RGB처럼 인코딩한다. 그 결과 미리 학습된 Wan 2.2 비디오 VAE로 인코딩 가능하고, 새 3D tokenizer를 만드는 대신 비디오 latent에 같은 형식으로 넣어 5B DiT가 motion token과 20차원 양팔 action을 함께 denoise한다(Figure 1, §III). 손에 든 빨간 병과 초록 병이 같은 경로로 이동하면 제어에 필요한 운동 정보는 비슷하다는 직관이다.
기존 연구와 무엇이 다른가?
DreamZero는 미래 비디오까지 생성하며 AMPLIFY는 이미지 공간의 sparse 2D point tracks를 예측한다. FloMo는 카메라 움직임을 교정한 dense 3D scene flow로 예측 타깃을 바꾸고, video pretrained Wan의 가중치만 가져오는 전략이다. 같은 장치·데이터 안의 VA/VMA 대비가 더 직접적인 인과 근거이며, 서로 다른 프로젝트의 DreamZero·AMPLIFY와 절대 성능을 비교할 때는 구현과 학습 레시피 차이를 함께 고려해야 한다.
방법론 · 아키텍처
§III-A–G에서 16-frame clip, 첫 RGB 조건 o0, 언어 명령 ℓ를 입력으로 둔다. SpatialTrackerV2가 첫 프레임 64×64 query에서 점 궤적을 추출한다. Fi(u,v)=pi−p0의 누적 3D 변위를 첫 camera frame에 표현하고 각 성분을 1/99 percentile clipping·0–1 rescale해 RGB 동영상처럼 렌더링한다. Frozen Wan 2.2 VAE는 motion latent를 만들며 frozen umT5-XXL은 언어를 cross-attention 조건으로 제공한다. Wan2.2 5B, 30-layer, width 3072 DiT는 LoRA r=64로 약 161M 파라미터만 학습하고, action token 선형 head를 덧붙인다(Appendix A). 기본 손실은 motion λf=1 + action λa=0.1 (비디오 λv=0); 인간 영상의 action loss는 mask한다. Mid-training은 EgoVerse/robot 혼합 14k step·batch512, fine-tuning은 YAM action data 1.5k step·batch256·λa=1. 추론은 10-step UniPC로 motion·action을 함께 복원하고 16개 행동을 실행한 뒤 재계획한다(§III-G).
모델 구조와 처리 흐름
개념적 처리 순서를 정리한 편집 다이어그램이며 원논문의 그림을 복제한 것은 아닙니다.
- 01
1. 액션 레이블 유무가 다른 두 데이터 스트림
비디오 V는 이미지 시퀀스+언어, 로봇 R은 여기에 20차원 양팔 행동을 더한다. EgoVerse 81h 인간 영상과 10h MolmoAct2 YAM + 3.7h 자체 YAM 데모 + 0.4h play, 별도 0.7h 인간 시연을 혼합한다. 사람 영상에는 로봇 motor 정답이 없으므로 action loss를 계산하지 않는다.
R: (o0:15,ℓ,a0:15), V: (o0:15,ℓ) - 02
2. 영상에서 3D 점 흐름 추출
SpatialTrackerV2가 첫 화면 64×64 점의 3D 궤적을 추정한다. 첫 카메라 좌표계로 정렬해 Fi=pi−p0를 계산하여 에고 카메라 이동에 의한 차이를 줄인다. 각 3축 변위는 1/99 percentile로 clipping한 후 RGB 채널로 코딩한다.
T=16, Q=4096, cumulative scene flow - 03
3. 기존 VAE latent 재사용
동일 Wan2.2 video VAE가 RGB-rendered flow를 encoding한다. VAE는 동결되며 새 토크나이저를 훈련하지 않는다. 출력은 시간 stride 4, 공간 stride 16의 시공간 토큰이고 조건용 첫 이미지 역시 VAE로 인코딩된다.
3D flow → RGB rendering → frozen VAE → z_flow - 04
4. 단일 DiT에서 scene flow와 action 공동 예측
언어는 frozen umT5-XXL을 통해 cross-attention에 들어간다. 5B DiT의 action은 20차원/step 선형 임베딩을 쓴다. 기본 학습 타깃은 미래 motion latent와 행동이며 비디오 예측 head는 오직 VA/VMA ablation에서 활성화한다.
Loss = λ_flow·L_flow + λ_action·L_action + λ_video·L_video - 05
5. 두 단계 mid-training → YAM fine-tune
Mid-training 14k optimizer step, batch512, motion loss weight1/action0.1; 81h 인간 motion에 action weight0을 적용. Fine-tune 1.5k step, batch256, 로봇 전용 sample만 사용하며 action weight를 1로 올린다. LoRA r=64, α=128, 약161M trainable parameters.
Appendix A Table II + Appendix B Table IV sampling weights - 06
6. 추론: 16개 행동을 10회 적분으로 생성
처음 장면+언어를 조건으로 UniPC 10-step에서 motion/action을 함께 생성한다. 정책은 16개의 action chunk를 실행한 뒤 새 관측으로 replanning한다. 저자 §III-G의 H100 약0.7s와 Appendix A-C의 B200 약0.9s 기술은 하드웨어 측정 문맥이 달라 한 값으로 통일하지 않는다.
16-step action chunk; 10-step UniPC; asynchronous overlap
Figure 1 — 3D 누적 변위를 RGB로 코딩해 비디오 VAE에 넣기
첫 이미지+명령에서 point tracker의 누적 scene flow를 RGB처럼 렌더링해 frozen Wan VAE로 넣는다. 저자 그림의 RGB는 실제 장면 생성 결과가 아니라 3축 3D displacement를 실은 부호화 이미지다.
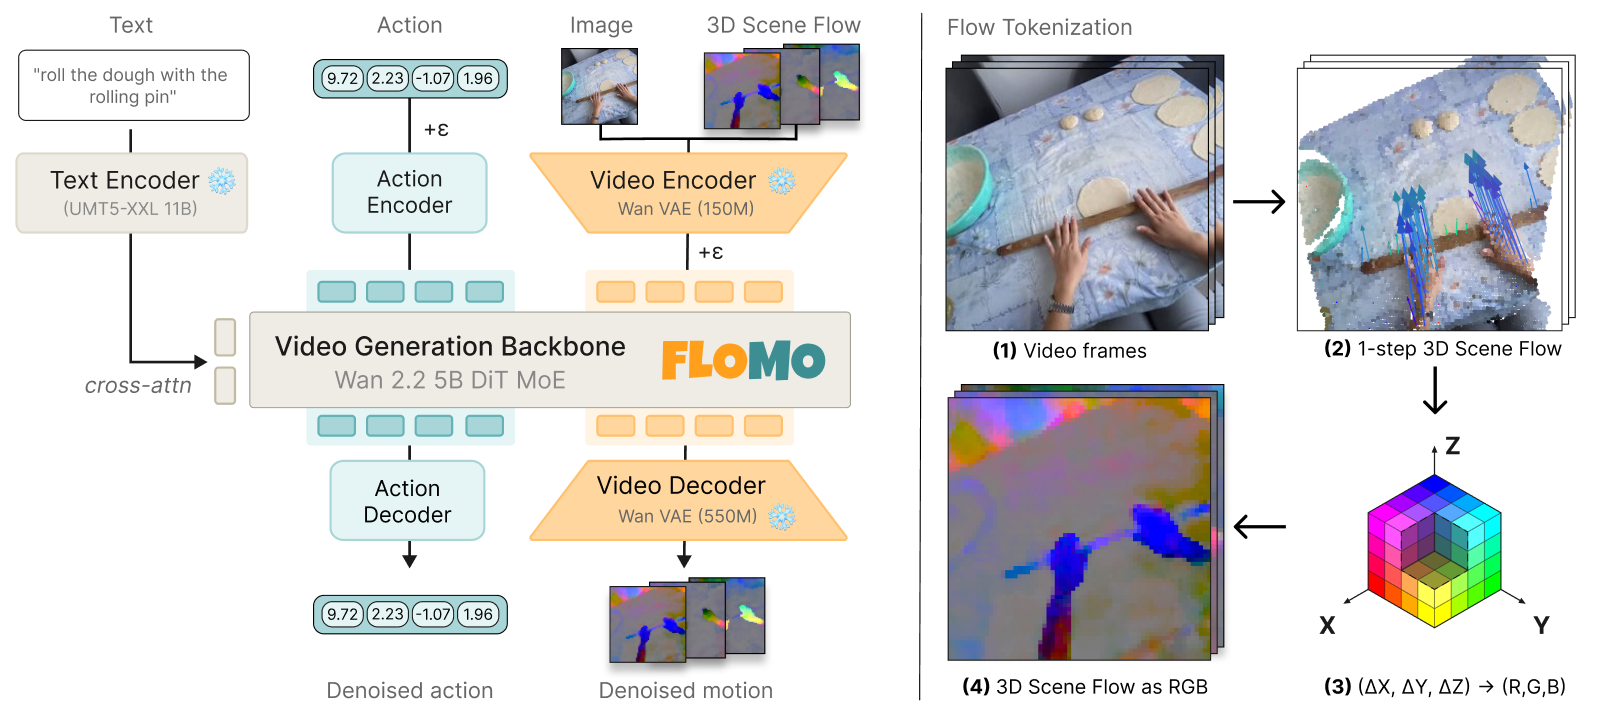
원문 캡션 일부 Figure 1: Given an image and text prompt, FloMo jointly predicts dense 3D motion (scene flow) and robot actions using a pretrained…
- 01
최초 RGB 조건과 future motion prediction target을 분리한다.
- 02
Q=4096 3D 점의 displacement가 RGB 3채널로 들어가는 변환을 추적한다.
- 03
Wan 2.2 5B DiT가 motion tokens와 action tokens를 공동 denoise하는 위치를 찾는다.
- 04
Human video는 action loss가 0이고 robot video만 action supervision을 받는다는 점을 연결한다.
한국어 해설은 이해를 돕기 위한 편집 해석이며 저자 논문에서 검증된 수치나 그림의 모든 패널을 대체하지 않습니다.
핵심 설계·학습 신호 해설
누적 scene flow가 표면 질감보다 중요한 이유
하이라이터가 파란색이든 노란색이든 ‘잡아서 그릇에 넣기’의 중간 제어 신호는 물체의 상대 3D 위치 변화다. RGB 예측에는 조명·재질 복원을 위한 자유도가 추가되지만 motion flow에는 그 부담이 작다. 이것은 논문 가설이며 다른 태스크까지 일반화된 수학적 보증은 아니다.
motion-video-action factorial ablation
동일 backbone과 학습 레시피에서 MA, VMA, VA를 비교해 영상 목표의 영향만 분리한다. 실제 YAM 3과제 평균 성공은 91/51/40%다. 핵심 결과는 비디오 타깃을 추가한 VMA가 MA를 개선하지 않았다는 점이다.
human-video transfer의 근거와 한계
문 닫기, 줄 당기기, 하이라이터 놓기는 로봇 학습 텍스트에 등장하지 않지만 인간 동영상의 관련 motion class에는 존재한다고 저자가 보고한다. human-video 제거 시 OOD 18/30→1/15이며 반복 횟수 다름에 주의해야 한다.
Attention과 동역학 probe의 역할
Figure 4는 VMA 모델의 attention share를 진단한 그림이다. late-middle layer에서 motion share 약55%, video는 깊은 층에서 약10%, 전체 평균 motion/video 약3배다. 별도 GT future probe에서는 action labels 1%에서 error 0.058 vs 0.074. 어느 것도 intervention한 원인 실험과 완전히 동일하지 않다.
실험과 주요 발견
실물 YAM의 Oven·Toolbox·Corn 세 작업은 각각 15회 실시했다. Figure 2에 보고된 평균 성공률은 MA(FloMo) 91%, VMA(video+motion+action) 51%, VA(video+action) 40%이며 Toolbox는 MA 87% 대 VMA/VA 각각 13%(§IV-B1). OOD Table I에서는 새 motion primitive Close Cabinet 6/10, 새 task Pull String 7/10, 새 object Highlighter 5/10으로 합계 18/30=60%, 평균 task progress 68%. 같은 30회 조건의 VMA·VA는 각각 2/30, AMPLIFY·DreamZero는 6/30이다. 인간 비디오 제거 실험은 1/15로 낮아지지만 반복 수가 5회/조건으로 달라 수치의 분산과 불확실성을 감안해야 한다. RoboTwin Easy 5 tasks×100 episode에서 FloMo 평균 63.6%, π0.5 44.8%, FAST-WAM 41.0%, BC 19.2%. 역동역학 probe는 action data 1%에서 GT motion 조건 error 0.058 대 GT future RGB 조건 0.074를 보고한다. Figure 4의 attention은 VMA 변형에서 action queries가 motion에 video보다 평균 약 3배 집중함을 보여주지만 인과적 중요도를 증명하진 않는다.
Figure 4 — Action query가 비디오보다 motion에 주의를 두는 이유
이 그림은 VMA(video+motion+action) 변형의 attention diagnostic이며 FloMo MA 모델의 성공률 그래프가 아니다. 1000개 validation samples의 layer/head 평균에서 action attention이 motion에 video의 약 3배 집중된다는 저자 설명을 검토한다.
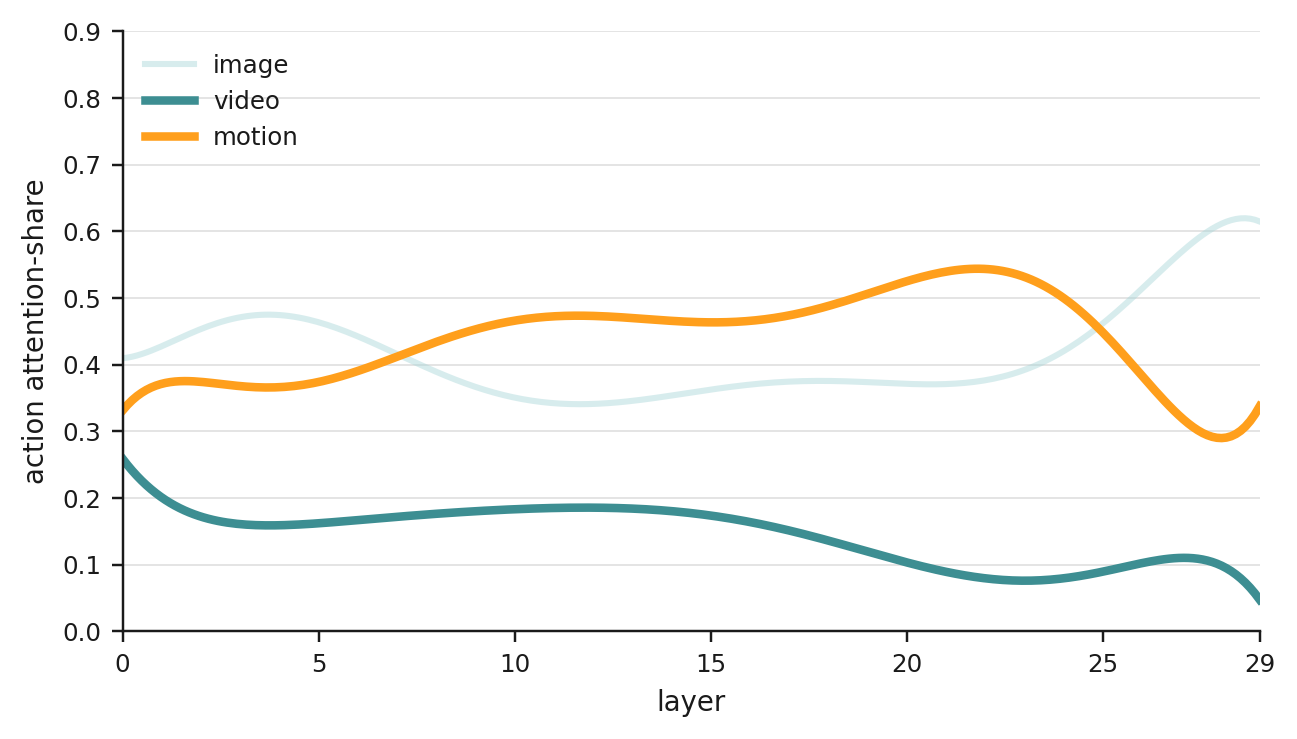
원문 캡션 일부 Figure 4: Action attention concentrates on motion tokens. Share of action-query attention to each input modality, averaged over attention heads and robot…
- 01
초기 층과 중후반 층에서 modality attention share가 달라지는 흐름을 읽는다.
- 02
Motion share가 late-middle layer에서 약 55%에 도달하는 부분을 확인한다.
- 03
Video share가 깊은 층에서 약 10%인 부분을 확인한다.
- 04
이 attention 차이는 상관적 진단이지 motion의 유일한 인과 효과 증명이 아님을 구분한다.
한국어 해설은 이해를 돕기 위한 편집 해석이며 저자 논문에서 검증된 수치나 그림의 모든 패널을 대체하지 않습니다.
실험 결과를 제대로 읽기
| 평가 항목 | 보고된 결과 | 해석 / 실험 조건 |
|---|---|---|
| 실물 YAM · ID, Figure 2 | MA 91% / VMA 51% / VA 40% | Oven·Toolbox·Corn 각 15회, 3과제 평균 success |
| Toolbox 미세 접촉 | MA 87% / VMA 13% / VA 13% | 15 rollouts, 뚜껑 틈을 열고 드라이버를 넣는 작업 |
| 실물 OOD · Table I | MA 18/30 = 60%; TP 68% | Cabinet 6/10, String 7/10, Highlighter 5/10; TP는 중간 단계 달성 비율 |
| OOD matched video variants | VMA 2/30, VA 2/30 | Table I, 동일한 10회/조건; AMPLIFY·DreamZero 6/30 |
| human-video 제거 | MA 18/30 → no-human 1/15 | Table I; 비교 분모가 달라 point estimate에 불확실성 주의 |
| RoboTwin Easy | FloMo 63.6 / π0.5 44.8 / FAST-WAM 41.0 / BC 19.2% | 5 tasks, task별 50 demos·5k training steps·100 evaluation episodes |
| inverse-dynamics probe | error 0.058 flow / 0.074 video | GT future signal, action data 1% subset, closed-loop 정책 수치 아님 |
| scene-flow 추출 비용 | 2.4s / 16frame window on L40S | Appendix B, 약72 GPU-hours / 30fps 영상 1h |
| attention share · Figure 4 | motion / video ≈ 3배 | VMA variant, 1000 held-out samples; correlation/attention analysis |
ⓘ 저자의 Figure 2·3은 별도 평가 그림으로 수치 출처는 해당 §IV와 Table I에 명시했다. OOD success(SR)와 두 단계 task progress(TP)는 다른 지표다. 실물 로봇 15회 또는 10회 성공률은 seed·하드웨어 변동으로 달라질 수 있다.
한계와 비판적 검토
Scene flow 생성은 별도 비싼 오프라인 추적을 요구한다. Appendix B에 따르면 L40S에서 16-frame window당 약 2.4초, 30fps 영상 1시간당 약 72 GPU-hour다. 실제 동작과 예측 scene flow가 공동 생성되지만 물리적으로 반드시 일치하도록 강제하지 않기 때문에 ‘정확한 flow = 정확한 action’은 아니다. 앞쪽 카메라에서 가린 물체, 추적기의 noisy 3D point, 비슷한 distractor 물체·모호한 언어는 저자가 직접 인정한 실패 원인이다(§V). 실물 세 작업의 15회 반복과 OOD 조건당 10회는 seed 변동·하드웨어 편차를 판단하기엔 제한적이다. Table I의 human-video ablation은 각 조건 5회여서 같은 표의 full-data 10회와 성공 비율을 점추정만으로 직접 동등 비교하지 말아야 한다.
내 연구에 적용한다면?
아래는 논문 저자의 검증 결과가 아니라, 논문에서 출발해 설계한 **후속 실험 제안**입니다.
같은 비디오 pretrained backbone에서 RGB 미래 예측보다 3D scene flow 목표가 더 높은 OOD 완료율과 낮은 inverse-dynamics sample complexity를 낸다.
동일 Wan 2.2 checkpoint·LoRA r64·YAM demos·batch·step을 고정하고 MA/VA/VMA 및 MA-no-human 4조건을 각 3 seed 훈련. Cabinet/String/Highlighter OOD task는 대상 object와 camera pose를 통제해 각각 30회 이상 실제로봇에서 재평가.
MA, VA, VMA, human-video 제외 MA, 2D-flow intermediate, oracle 3D tracker 기반 상한
strict SR·subtask TP, instance별 3D flow endpoint error, action L2, replanning latency, camera occlusion failure, 원본 RGB grounding accuracy
SpatialTrackerV2 오류·calibration drift·front-view occlusion이 action decoding을 왜곡할 수 있다. 사람 영상 도메인의 camera ego-motion 정렬 실패와 72 GPUh/h 데이터 추출 비용도 기록한다.
원문을 읽으면서 확인할 4가지
- Figure 1에서 scene-flow RGB가 원래 카메라 RGB를 뜻하지 않는다는 점을 확인한다.
- §III Eq.(2–4)와 Appendix B에서 초기 camera frame 정렬·point tracker·1/99 percentile 범위를 확인한다.
- Appendix A Table II의 14k/1.5k step과 action loss 0.1→1의 의미를 따진다.
- Table I의 6/10,7/10,5/10과 no-human 1/15의 분모 차이를 눈에 띄게 표시한다.
- RoboTwin Easy는 100 episode×5 tasks의 simulation으로 실물 ID 15회와 섞지 않는다.
- Figure 4가 VMA 모델의 attention 분석이라는 점을 원문 caption과 대조한다.
읽고 나서 남는 질문
- Figure 1의 cumulative flow를 instantaneous velocity로 바꾸면 3D tracker noise와 정밀 접촉 성능이 어떻게 변하는가?
- 새 카메라 시점에서도 초기 camera frame 정렬을 정확히 유지할 수 있는가?
- Table I의 Pull String 7/10이 인간 영상에서 어떤 움직임을 전이한 결과인지 robot-only 데이터에서 검증되는가?
- Figure 4의 attention 3배가 실제 행동 제어에 중요한 feature인지 patch occlusion으로 입증할 수 있는가?
- 고정 16-frame action chunk 사이 갑작스러운 외란에 얼마나 빠르게 재계획하는가?
원문 / 출처 확인
편집자가 작성한 초록 기반 한국어 요약이며 공식 영문 초록의 원문/번역이 아닙니다.
한 프레임의 픽셀을 예측하는 것보다 그 안의 3D 점들이 어디로 이동하는지 예측하는 편이 로봇 행동 학습에 유리할까? FloMo는 액션 라벨 없는 인간 시점 영상과 라벨 있는 양팔 로봇 동작을 같은 motion intermediate로 묶는다. 본문은 실물 작업 실패·성공 조건과 비디오 예측 대조군까지 검토한다.
해설은 논문 저자들의 진술과 편집자의 비판적 질문을 구분합니다. 특정 지표·인과관계·재현성을 판단할 때는 반드시 원문의 실험 설정을 확인해 주세요.