▧ 원문 §III–V, Figure 2·3과 대조한 편집 해설 · 독립 재현은 별도 · 상세 연구 노트 포함 · 원논문 Figure 문맥별 해설
핵심을 먼저 읽기
미래 영상이 보기 좋다는 것과 로봇 명령에 따라 움직인다는 것은 다르다. PrimeSim은 3개 카메라 화면·31D 통합 행동표현·시간 정렬된 action conditioning을 통해 제어 가능성을 높이고, 4단계 후속학습과 hierarchical KV memory로 긴 rollout의 자기 오차 누적을 억제하려 한다.
이 논문의 성공 조건: 생성 영상의 PSNR보다, 명령이 실제 동작을 바꾸는지·카메라가 서로 같은 세계를 보는지·자체 생성된 프레임을 반복 입력해도 붕괴하지 않는지 확인한다. §2의 자료 통합, §3의 action/multiview 및 posttraining, §4의 WorldSimProbe/EWMBench/LIBERO와 Appendix A/B를 대조했다. 저자의 simulator 실험과 실제 하드웨어 안전성은 구분한다.
연구가 풀려는 문제
월드 모델을 학습 시뮬레이터로 사용하려면 명령한 팔이 움직였을 때 물체가 그 실제 움직임 때문에 변해야 한다. 단순 비디오 생성기는 카메라별 불일치, 명령과 다른 로봇 팔 동작, 자기 생성한 프레임을 다시 입력하는 동안 축적되는 오류 때문에 멀쩡한 동영상을 내더라도 정책 훈련에는 잘못된 보상을 줄 수 있다. 특히 뒤늦게 보이지 않는 물체 위치가 바뀌는 문제가 치명적이다. PrimeSim은 영상 선행학습을 유지하면서 로봇의 행동 인터페이스, 다중 카메라 일치, 수십 초 rollout 연속성을 함께 다룬다(§1–3).
핵심 아이디어
사전학습된 Wan2.2-TI2V-5B를 로봇 22종·30,110시간 데이터로 midtrain해 action-conditioned 3-view 비디오 생성기를 만든 뒤, causal attention→4-step consistency distillation→self-rollout asymmetric DMD→episode-level memory로 단계적으로 전환한다. 행동은 플랫폼마다 서로 다른 관절 정의를 31D 슬롯에 맞추고, action과 미래 frame이 대응하도록 attention mask와 residual adapter를 함께 사용한다. 비유하면 ‘관찰 영상으로 그림을 잘 그리는 모델’을 ‘로봇 조이스틱 입력에 맞춰 상태를 갱신하는 게임 엔진’으로 변화시키는 작업이다(§2–3, Figure 1).
Figure 1 — 데이터 규모·행동 조건·simulator 검증을 구분
저자 Figure 1은 30.1k-hour corpus, 3-camera/action-conditioned 생성기, sim fidelity와 policy 평가의 서로 다른 주장을 묶은 teaser다. r=0.99는 LIBERO 시뮬레이터와의 policy 성공률 Pearson 상관에 관한 것이다.
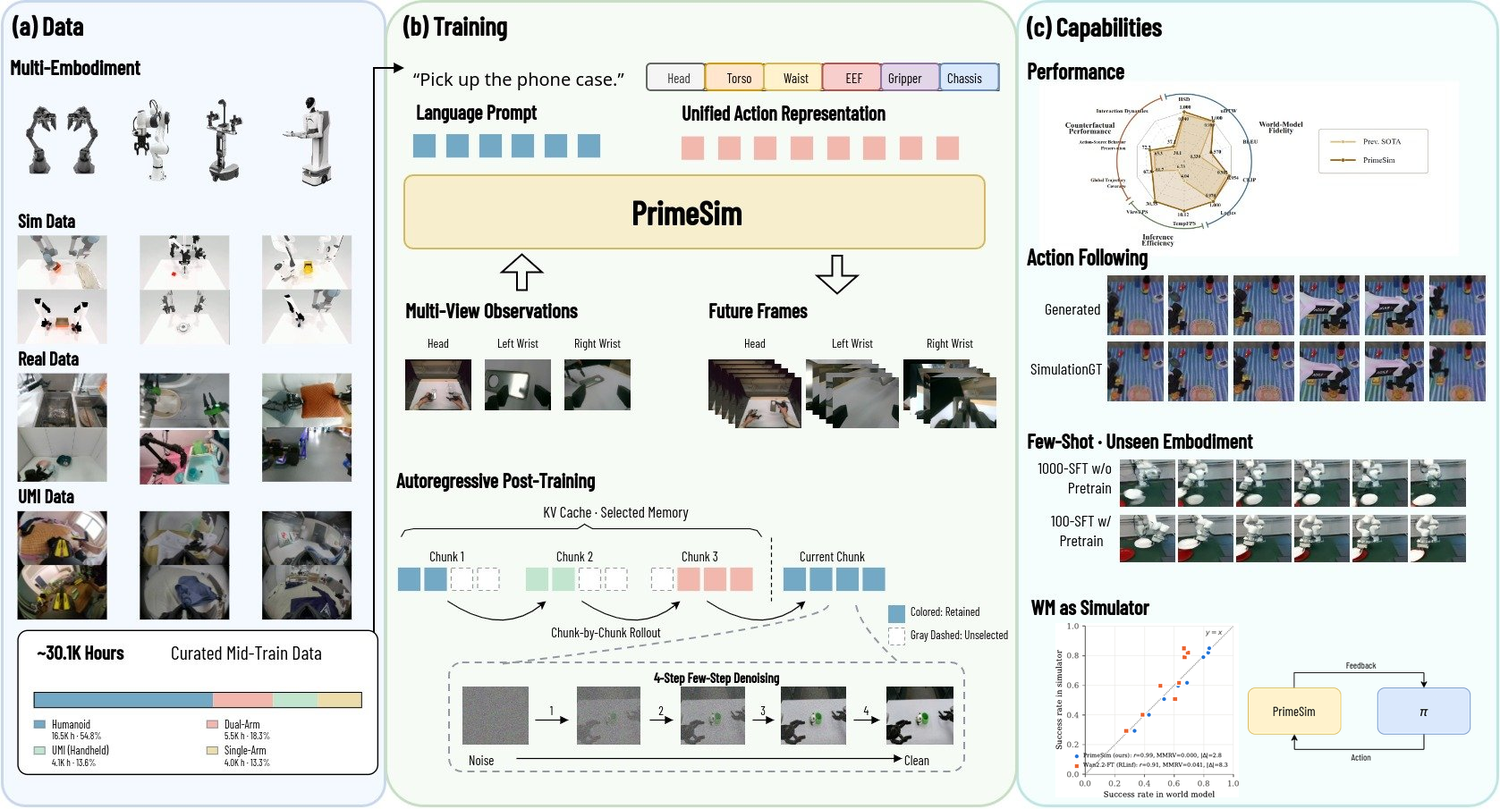
원문 캡션 일부 Figure 1 : PrimeSim. (a) The midtraining corpus: roughly 30.1K hours of curated robot data spanning humanoid, dual-arm, single-arm and handheld UMI…
- 01
(a) robot 형상 및 실물/시뮬레이션 데이터 혼합을 파악한다.
- 02
(b) 언어·31D actions·3-camera 조건이 다음 프레임에 연결되는 방식과 posttraining memory를 본다.
- 03
(c) simulator에 대해 성능을 평가한 부분은 현실 하드웨어 RL 성적이 아님을 구별한다.
- 04
상관계수 r=0.99는 단 8정책의 LIBERO-Spatial 평가임을 Table/본문에서 확인한다.
한국어 해설은 이해를 돕기 위한 편집 해석이며 저자 논문에서 검증된 수치나 그림의 모든 패널을 대체하지 않습니다.
기존 연구와 무엇이 다른가?
PrimeSim은 행동을 직접 출력하는 VLA나 action-diffusion 정책이 아니라, 주어진 행동을 입력으로 받아 다음 RGB 세계 상태를 예측하는 simulator다. HiLo-WAM(2611.05023)은 예측 시각 상태와 action을 공동 생성해 제어 정책을 강화하지만, PrimeSim은 정책 평가·RL 학습에 사용할 world-model environment에 더 무게를 둔다. 속도·정확도 점수는 모델 종류보다 우선 평가 계약과 action-conditioning 여부로 비교해야 한다.
방법론 · 아키텍처
데이터 엔진은 영상 품질·행동 이상치·시간/카메라/언어 정렬·좌표계 통일을 수행한다. 각 샘플은 head/left wrist/right wrist 등 최대 3개 시각으로 매핑하고 영상은 10Hz, 행동은 최초 상태를 기준으로 상대화한다. 31D action slot과 2-layer MLP token, framewise shifted-diagonal attention, direct action-frame adapter를 이용한다. 30개 DiT block 중 2개는 view 내부 attention, 3번째는 view 간 global attention을 수행하고 camera token으로 구별한다. Midtrain은 조건부 latent flow matching. Posttrain은 chunk-causal 50-step 생성에서 4-step student로 증류하고, self-rollout과 global-sink/slow/local cache를 이용한 episode-level adaptation으로 확장한다(§2–3, Appendix A).
모델 구조와 처리 흐름
개념적 처리 순서를 정리한 편집 다이어그램이며 원논문의 그림을 복제한 것은 아닙니다.
- 01
1. 이종 로봇 30,110시간 데이터 정리
20개 dataset family, 1,773개 LeRobot 저장소, 약 152만 에피소드, 22개 플랫폼·총 약 23.8억 프레임을 합친다. 품질 낮은 영상/행동 로그를 필터링하고 10Hz로 재표본화한다. 실제:시뮬레이션 비중은 시간 기준 약 84:16; 3-view 슬롯은 없는 카메라를 primary 이미지로 복제해 맞춘다.
Robot demonstrations → aligned (video,action,instruction) triples - 02
2. Embodiment를 31D 행동 슬롯으로 일치
end-effector pose·그리퍼·head/torso/waist·chassis velocity 등을 공통 슬롯에 매핑하고 사용하지 않는 슬롯은 0으로 둔다. window 시작 상태 기준 상대 pose (T₀⁻¹Tₜ)로 기준점을 고정하며 quaternion 성분 순서는 (x,y,z,w)로 통일한다. 다른 로봇의 절대 좌표 원점 차이가 정규화된다.
relative action chunk + 31D unification - 03
3. Midtrain: 정확한 action-frame 대응
Wan2.2-TI2V-5B의 사전학습 영상 모델에서 시작한다. 각 미래 frame은 그 frame으로 이동을 일으킨 선행 action만 참조하도록 shifted-diagonal attention을 제한하고, 별도 action-frame adapter가 해당 action feature를 frame token에 직접 더한다. 두 경로는 temporal alignment와 signal strength를 각각 담당한다.
A_t → framewise mask + residual adapter → predicted RGB - 04
4. 카메라 세 줄의 일치 유지
30개 DiT block은 두 개씩 카메라 내 attention, 세 번째 block은 3개 view에 global attention을 수행한다. 각 view를 구분하는 learned camera token이 함께 들어간다. 영상의 팔 위치·물체 상태가 세 시점에서 동시에 일어나도록 학습한다. Midtrain 목적함수는 joint multiview latent flow matching이다.
Head / wrist-L / wrist-R → shared world evolution - 05
5. Posttrain 1·2: Causal chunk와 4-step distilled student
Bidirectional fixed-window generator를 이전 chunk만 읽는 chunk-causal 모델로 바꾸고 teacher forcing으로 학습한다(Stage 1). 50번 denoising하던 causal teacher의 국소 ODE update를 4-step student가 근사하게 consistency distill한다(Stage 2). 약한 모델에게 미래 정답 frame을 주지 않기 위한 준비다.
50-step causal teacher → 4-step causal student - 06
6. Posttrain 3: 자기 history의 오류를 학습
고정된 ground-truth context가 아니라 student가 직접 생성한 frame을 다음 입력으로 주는 self-rollout을 반복한다. 동결된 bidirectional teacher와 student의 fake-score network를 비교하는 asymmetric DMD 학습으로 drift를 줄인다. student는 LoRA adapter를 갱신하고 critic은 generation마다 별도 학습한다.
self-conditioned rollout + frozen real-score + learned fake-score - 07
7. Posttrain 4: episode-level와 hierarchical KV memory
짧은 clip 대신 episode 전체에서 누적 error를 보며, KV cache에는 global sink(초기 장면), sparse slow memory(오래된 핵심 상태), dense local memory(최근 움직임)를 둔다. Appendix의 대표 slot 설정은 3+9+9=21개. 정책이 장기간 명령할 때 새 프레임은 더 이상 실제 정답 future frames를 이용하지 않는다.
Hierarchical cache 3/9/9 → open-ended autoregressive generation
Figure 2 — 30,110시간이 ‘양질의 행동-비디오 쌍’이 되기까지
원문 Figure 2는 teleoperation·UMI·simulation 자료에서 영상/행동 품질을 걸러내고, 시각·타임스탬프·좌표계를 맞추는 실제 데이터 처리 흐름이다. Figure 2 자체가 모델의 DiT 구조도는 아니며 그 구조는 원문 Figure 4에 있다.
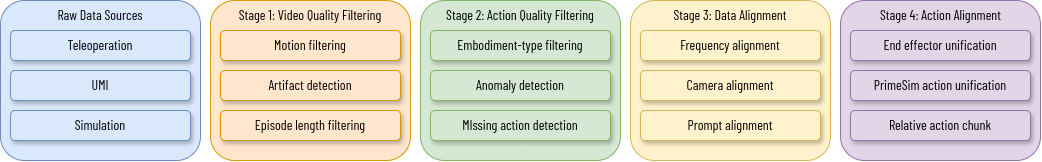
원문 캡션 일부 Figure 2 : Overview of the data pipeline. Raw demonstrations from teleoperation, UMI, and simulation are converted through four stages: video quality…
- 01
영상 품질에서 JPEG artifacts·짧은 episode·motion outlier를 검출한다.
- 02
행동 값의 불연속/손상과 결측을 찾아 제외하는 조건을 확인한다.
- 03
10Hz 재표본화·최대 3개 camera slot과 텍스트 prompt 정렬을 추적한다.
- 04
end-effector FK, quaternion (x,y,z,w), 첫 프레임 기준 relative chunk 변환을 확인한다.
- 05
저자 Figure 4의 actual model architecture와는 역할이 다른 데이터 파이프라인 이미지임을 명시한다.
한국어 해설은 이해를 돕기 위한 편집 해석이며 저자 논문에서 검증된 수치나 그림의 모든 패널을 대체하지 않습니다.
핵심 설계·학습 신호 해설
이미지 품질이 높은 것만으로 행동 충실도는 확인되지 않는다
WorldSimProbe T1–T5는 작은 action perturbation, 다른 궤적, action source, 접촉 없는 반사실 상황, interaction dynamics를 따로 측정한다. 예컨대 팔이 안 움직였는데 물체가 밀리는 영상은 화질이 높아도 시뮬레이터 계약을 어긴다.
31D 상대 행동표현과 시간 정렬은 서로 다른 문제
상대 행동은 로봇마다 다른 절대 원점을 제거한다. shifted-diagonal attention은 어떤 action이 어떤 RGB frame 변화를 지배하는지 지정한다. adapter는 attention이 action signal을 무시하지 못하도록 직접 주입한다. Table 9/10 각각 representation과 두 경로를 별도로 ablate한다.
3개 view는 입력을 단순 이어 붙이지 않는다
카메라 아이디와 interleaved intra-/cross-view attention을 통해 각 view 고유 움직임을 유지하면서 동일한 물체의 일관성을 맞춘다. 단일 in-house 플랫폼 조건 Table 11에서 단순 frame concatenation PSNR 16.30, view token 추가 23.78, intra-view attention 추가 24.56이다.
Four-step FPS는 더 빠른 샘플러의 수치
Stage 1 causal 50-step은 1.12 TempFPS, Stage 2 four-step은 10.04, Stage 3은 10.12다(Table 6). 다른 월드모델의 50-step 또는 다른 해상도 추론과 이를 같은 하드웨어 비용으로 간주하면 안 된다. 자체 KV가 성장하는 긴 rollout에서는 7.63 TempFPS라는 단서도 있다.
Rolling cache 대비 3/9/9 계층 기억
21 temporal latent slot 예산을 동일하게 두고, rolling(3+18) 평균 PSNR 18.709, hierarchical(3+9+9) 19.519로 비교한다. 마지막 window 성능과 처음 대비 degradation도 후자가 우수하다. 이는 긴 episode의 객체 상태 보존을 위한 증거이나 모든 환경에서의 물리학적 일치를 보증하진 않는다.
정책 평가의 상관관계와 RL의 범위
LIBERO-Spatial 10 tasks×30 states에서 8개 OpenVLA-OFT 정책의 순위를 예측했을 때 Spearman rho=1.00, Pearson r=0.99. 분류기 성공 판정은 LIBERO simulator의 privileged predicate와 다르다. GRPO 200 step 개선도 실제 hardware가 아니라 physics simulator에서 확인됐다.
실험과 주요 발견
WorldSimProbe Table 1에서 PrimeSim은 다섯 행동·상호작용 suite 중 네 개 최고: T1 70.2(최고 LingBot-VA 77.0), T2 67.9, T3 72.3, T4 85.7, T5 37.1, 평균 66.6. EWMBench Table 2 전체 6.09는 GE-Sim LTX 5.82보다 높지만 텍스트 조건 모델과는 동일한 조건이 아니다. 단일 A100, 288×384×3-view, four-step steady state의 10.12 temporal FPS 및 30.35 view-frame FPS는 원문 품질 평가 설정(192×256, 50 step)과 다르다. LIBERO-Spatial 8정책×300 초기상태의 성공률 순위 상관은 Spearman 1.00, Pearson 0.99이며, PrimeSim 내부 GRPO 200 step 후 물리 시뮬레이터 성공률은 61.7%→73.2%다(§4.1–4.4).
실험 결과를 제대로 읽기
| 평가 항목 | 보고된 결과 | 해석 / 실험 조건 |
|---|---|---|
| Midtraining corpus | 30,110 h / 22 platforms / 1.52M episodes | Appendix Table 12, Figure 3: 20 dataset families, 84:16 real:sim |
| WorldSimProbe (LIBERO) | Mean 66.6; best 4 / 5 suites | Table 1: T1 70.2는 LingBot-VA 77.0보다 낮음 |
| EWMBench Overall | 6.09 vs GE-Sim(LTX) 5.82 | Table 2: action-conditioned 비교; 21 episodes, 50-step quality |
| Midtraining held-out platforms | 100–200 gradient steps | Table 4: xArm7 200, ViperX300 100, UMI200; pretrained backbone은 2000 내 미달 |
| Stage1→Stage3 throughput | 1.12 → 10.12 temporal FPS | Table 6: causal teacher 50 steps vs Stage3 student 4 steps |
| A100 single GPU latency protocol | 10.12 TempFPS /30.35 ViewFPS | Table 3: 288×384×3views, bfloat16 batch1; end-to-end control 아님 |
| Hierarchical memory PSNR | 19.519 vs rolling 18.709 | Table 8: 10 RoboTwin episodes, 동일 21-slot budget |
| 8-policy simulator-ranking fidelity | Spearman 1.00 / Pearson 0.99 | Figure 9(a): LIBERO-Spatial 300 matched states, sim only |
| GRPO RL 200 steps | LIBERO simulator 61.7%→73.2% | Figure 9(b): model-generated reward로 학습하고 physics sim으로 평가 |
ⓘ 품질 실험은 대개 192×256, 50-step과 모델별 프로토콜에 기반하나 Table 3의 속도는 288×384×3-view, 4-step의 다른 조건이다. Policy evaluation과 GRPO 효과는 모두 LIBERO physics simulation에서의 검증이며 실제 로봇 제어 성공률로 인용하면 안 된다.
한계와 비판적 검토
정량 및 모든 정책 closed-loop 검증은 시뮬레이션에 기반하며 실제 하드웨어에서 PrimeSim으로 정책을 훈련한 결과는 아니다. 100–200 step 적응은 zero-shot이 아니라 플랫폼별 데이터를 사용한다. 10.12 TempFPS는 모델 단독 생성 속도이지 정책과 로봇을 연결한 end-to-end control FPS가 아니다. 비교 모델 간 이미지 해상도·비디오 길이·denoising budget은 통일되지 않았다. 품질 점수에서 의미적·논리적 차원은 높지만 지역 action calibration(T1)은 선두가 아니다. 일부 자료는 비공개 in-house이며 독립적인 데이터 동일 재현에 제약이 있다(§4.1.3, §6).
내 연구에 적용한다면?
아래는 논문 저자의 검증 결과가 아니라, 논문에서 출발해 설계한 **후속 실험 제안**입니다.
미래 프레임별 action alignment와 세 시점의 view identity, self-generated memory를 함께 제공할 때 동영상 재현을 넘어 counterfactual action-conditioned simulator의 신뢰성이 높아진다.
공개 가능한 LIBERO-Spatial 10 tasks×30 initial states에서 저장된 동일 8개 정책을 고정해 WorldSimProbe T1–T5와 policy ranking을 재측정한다. 원본 미공개 corpus 전체 복제 대신 공개 데이터·1개 로봇에서 31D 상대 action, dual-path, multiview mask 및 cache ablation을 실행한다.
Wan2.2 prior-only, absolute vs delta vs first-frame relative actions, unmasked attention vs framewise+adapter, naive concat vs camera tokens, rolling 21 slots vs hierarchical 21 slots
T1–T5, action-to-realized displacement error, view consistency, scene drift per 100 frames, strict physics-sim policy success, rank correlation with bootstrap CI, TempFPS/ViewFPS at matched geometry
비공개 데이터 재현 불가, classifier reward hacking, physics-sim과 실제 robot의 도메인 차이, 비교 FPS의 해상도·denoising 편차를 명확히 제한해야 한다.
원문을 읽으면서 확인할 4가지
- Figure 1의 corpus/architecture/simulator 사용 세 패널을 구별하고 r=0.99가 물리 로봇 성적이 아닌 LIBERO 정책평가 상관임을 표시한다.
- Figure 2의 영상 필터·행동 이상치·정렬·표현 통일에 해당하는 단계와 Appendix Table 12의 시수 계산을 확인한다.
- §3.2 Figure 4 설명에서 shifted diagonal과 action-frame adapter, interleaved view attention 각각의 목적을 적는다.
- §3.3 Stage 1→4에서 어떤 teacher를 동결하고 어느 단계에서 self-generated history를 사용하는지 도식화한다.
- Table 1의 T1 local calibration 열을 다른 네 지표와 함께 읽는다.
- Table 3의 TempFPS와 ViewFPS, 해상도·denoising steps·긴 episode 7.63 수치를 구분한다.
읽고 나서 남는 질문
- Figure 1(c)의 LIBERO 상관계수가 실제 로봇의 sim-to-real 성능까지 보장하는가?
- Figure 2의 데이터 파이프라인에서 회전 quaternion 순서와 10Hz 동기화 오류는 어떤 방식으로 검출되는가?
- Table 3의 10.12 TempFPS와 30.35 ViewFPS를 비교 모델의 영상 해상도 및 step과 함께 어떻게 해석해야 하는가?
- Table 8의 global/slow/local memory가 같은 21-slot rolling cache 대비 어떤 조건에서 덜 drift하는가?
- WorldSimProbe T1의 낮은 local calibration이 실제 RL reward hacking으로 이어질 가능성을 어떻게 평가할 것인가?
원문 / 출처 확인
편집자가 작성한 초록 기반 한국어 요약이며 공식 영문 초록의 원문/번역이 아닙니다.
Action-conditioned multiview video generator를 훈련 데이터 엔진, 두 개의 행동조건 경로, 카메라 간 정보교환, causal distillation과 자기 생성 history 학습을 통해 world-model simulator로 바꾸는 연구. 저자 실험의 세부 조건과 한계를 구별한다.
해설은 논문 저자들의 진술과 편집자의 비판적 질문을 구분합니다. 특정 지표·인과관계·재현성을 판단할 때는 반드시 원문의 실험 설정을 확인해 주세요.