▧ 원문 §III–V, Figure 2·3과 대조한 편집 해설 · 독립 재현은 별도 · 상세 연구 노트 포함 · 원논문 Figure 문맥별 해설
핵심을 먼저 읽기
목표까지 가는 것과 정밀하게 ‘버티는 것’은 별도 문제다. PolicyIK는 제어기 내부의 누적 joint reference까지 관측하게 하고, mm 단위 pose 신호와 dwell reward를 결합해 실물 OpenArm 최종 5초 유지 43/60을 보고한다(§3–5, Table 3).
핵심 판단: IK는 pose가 근처에 온 것만으로 성공이 아니다. 목표 위치 1mm 이내와 자세 0.2° 이내, 그리고 충분한 시간 유지가 중요하다. Table 1의 simulation 최종 1초 평균, Table 3의 hardware 최종 5초 연속, Table 2의 VLA task completion은 서로 다른 지표이므로 하나의 성공률로 뭉치지 않는다.
연구가 풀려는 문제
VLA가 컵을 집기 위해 gripper 목표 포즈를 지정해도 손목의 IK 오차가 몇 mm만 나면 접촉에 실패할 수 있다. 특히 7-DoF 중복 자유도와 joint limit 부근, 하중에 따른 PD 위치제어 오프셋 때문에 같은 관절 상태 q라도 제어기에서 쌓아 둔 명령 참조 z는 다를 수 있다. Damped least squares(DLS)·QP·kinematic MPC는 잘 알려진 폐루프 해법이나 장애물·하중·한계 근처의 정밀 도달과 흔들림 없는 유지에는 튜닝과 계산이 필요하다. 이 논문의 질문은 task-specific pick-and-place를 학습하지 않고도 재사용 가능한 pose-tracking IK를 RL로 학습할 수 있는가이다(§1–3).
핵심 아이디어
PolicyIK는 한 번에 관절 절대각을 출력하지 않는다. 정책의 7차원 행동을 다음 joint position reference에 더하는 increment로 만들고, ‘명령한 기준 위치와 실제 측정 위치의 차이’도 관측하게 한다. 멀리 있을 때는 큰 보폭으로 움직이고, 목표가 가까워지면 coarse/fine pose error 채널과 gain schedule이 미세 보정을 지원한다. 보상은 단순 거리 감소만이 아니라 목표 오차에 새로 근접한 ‘progress’와 허용 범위 안에서 지낸 시간 ‘dwell’을 각각 지급한다. 따라서 ‘순간 통과’가 아니라 그리퍼를 그 자리에서 고정하는 습관을 학습한다(§4, Figure 2).
기존 연구와 무엇이 다른가?
Jacobian의 국소 선형화에 기초한 DLS·QP, kinematic MPC는 본래 알려진 제어 수단이며 PolicyIK의 장점은 목표 pose를 상호작용 기반으로 정밀 추종·유지하도록 직접 최적화한다는 점이다. 그러나 LIBERO 조작 태스크에선 tuned DLS 96.7%가 PolicyIK 95.7%보다 높았다. 강화학습은 ‘최고로 정확한 범용 IK 해법’을 증명했다기보다 특정 joint-position reference 환경과 평가 목표에서 튜닝 부담과 precision/holding 개선을 보였다고 제한해야 한다.
방법론 · 아키텍처
§3은 goal T_g∈SE(3), 상태 (q, qdot, 직전 joint reference z, 직전 행동), action Δz∈R7을 정의한다. position controller가 누적 참조 z를 추종하며 명령과 실제의 차이를 입력에 남긴다. §4.2의 3개 keypoint pose delta와 coarse(1cm,20°)/fine(0.5mm,0.25°) 채널은 mm·0.2° 잔차를 확대한다. gain β는 위치·회전오차의 임계치에 따라 낮아져 미세 수정에 필요한 작은 step을 만들고, reward는 tracking + best-so-far progress + dwell − 움직임·관절한계 비용이다(Figure 2, Eq.2–7). 시뮬레이션은 Isaac Sim OpenArm 7-DoF, 4,096 병렬 env·30Hz, PPO, 12초 rollout 중 4초마다 target을 바꾸어 3번 시도한다. 실물은 simulation weights가 아닌 별도 FlashSAC+HER 기반 online RL로 학습한다. Appendix H는 goal relabel·near-goal replay·reverse curriculum·latent-alignment critic을 상세히 설명한다.
모델 구조와 처리 흐름
개념적 처리 순서를 정리한 편집 다이어그램이며 원논문의 그림을 복제한 것은 아닙니다.
- 01
1. 목표 pose와 제어 상태 정의
7-DoF OpenArm의 목표는 SE(3) 위치·회전, 정책이 보는 상태는 측정 q, qdot, 이전 z, 이전 action이다. Forward kinematics로 현재 끝단 pose를 얻고 목표와 비교한다. 서보는 새로운 z를 한 control period 추종한다.
Goal T_g=(R_g,p_g); state (q,qdot,z,a_prev) - 02
2. 누적 joint reference의 기억
정책은 절대 joint 각도 대신 7D 참조 increment를 생성하고 이전 z에 누적한다. 이미 PD 제어기에 걸려 있는 z−q offset을 상태에 넣어 동일 측정 q에서 필요한 holding torque가 서로 다를 수 있음을 반영한다.
Δz → accumulated z; command-state feedback (z−q) - 03
3. coarse/fine pose 오차를 동시에 관측
현재 끝단 좌표계에서 위치 및 SO(3) log rotation error를 coarse (1cm,20°), fine (0.5mm,0.25°)로 normalize·clip한다. 0.2° error가 coarse 범위에서 눈에 띄지 않는 문제를 줄인다. 3개 keypoint delta도 병행한다.
Eq.(4–5): 3 point delta + v_coarse + v_fine - 04
4. error-dependent action gain
모션 시작 시 크게, 목표 접근 시 작게 관절 참조 업데이트를 적용한다. β는 위치·자세 오차가 임계치 아래로 내려오면 floor까지 줄어든다. 고정 gain일 때 속도와 종단 precision 사이의 trade-off가 드러난다.
Eq.(6): β(e_pos,e_rot) × joint reference increment - 05
5. tracking/progress/dwell reward
tracking은 접근을 유도, progress는 이전 최저 error를 갱신하도록, dwell은 strict tolerance 내부에 머무는 매 시점에 보상을 준다. joint velocity와 limit cost로 불안정한 correction을 억제한다. 목표에 닿는 순간 episode를 종료하지 않고 유지 동작까지 훈련한다.
Eq.(7): track + progress + dwell − motion − limit - 06
6. 병렬 PPO 시뮬레이션과 별도 실물 FlashSAC
Isaac Sim은 4,096 env·30Hz·5.3초 테스트, PPO 학습은 12초 안에 목표를 세 번 바꿔 이동성을 키운다. 실물은 FlashSAC+HER·near-goal replay 75%·reverse curriculum을 사용하여 약 120k online transition을 수집한다(Appendix H Table 11).
Sim PPO ≠ hardware FlashSAC; 평가 조건 분리 - 07
7. VLA의 pose 명령을 실제 관절 참조로 실행
π0.5-LIBERO가 생성한 end-effector 명령은 고정 Panda operational-space adapter를 거쳐 pose reference로 바뀐다. PolicyIK는 이 pose만 보며 action을 산출한다. pick-and-place 데모로 IK 자체를 학습하지 않았다는 것이 이 모듈 교체 실험의 요지다.
§5.1.3: LIBERO-Object 10 tasks × 50 starts × 3 runs
Figure 2 — 현재 q가 아니라 누적 reference z까지 쓰는 제어기
저자 Figure 2의 정책은 7D joint-reference increment를 산출하고 gain β를 곱해 쌓는다. 기존 PD loop는 누적 z를 추종하며, 정책은 z−q feedback으로 서보 오프셋을 인식한다. 그림의 색상별 블록이 §4.1–4.3의 세 설계를 표시한다.
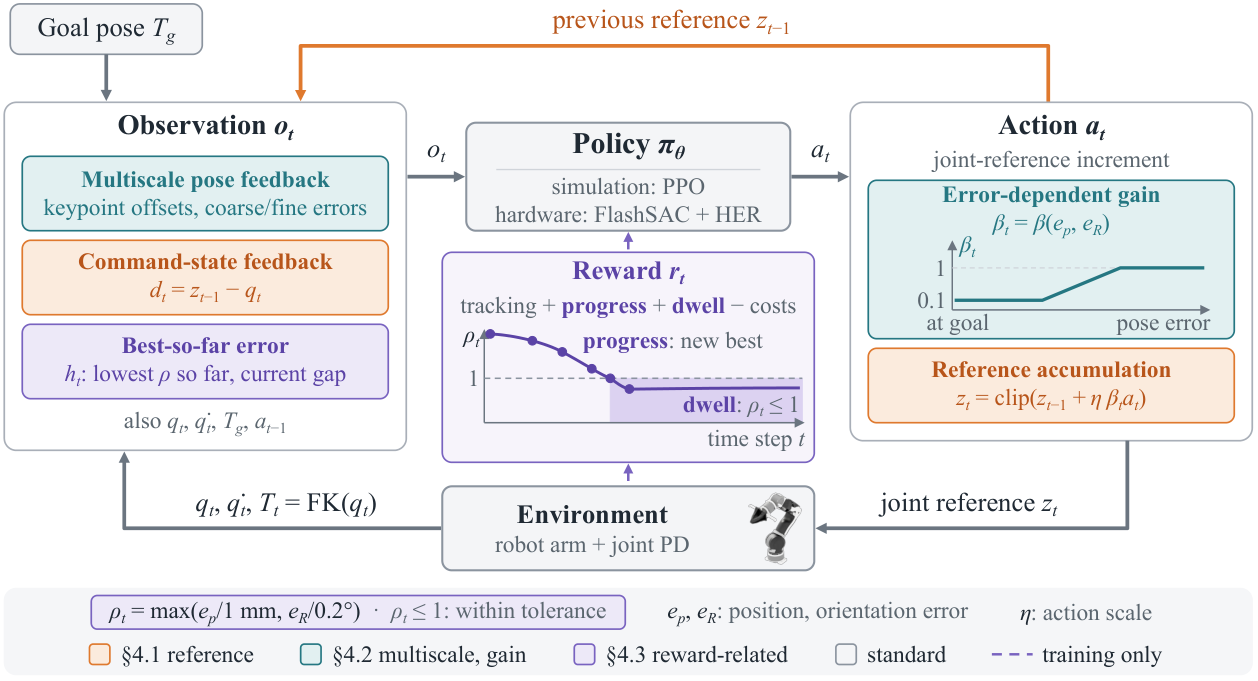
원문 캡션 일부 Figure 2: PolicyIK control formulation. At each step, the policy maps the observation to a joint-reference increment, which is scaled by the…
- 01
실측 q와 누적 명령 z를 구분한다.
- 02
δz를 생성한 후 β scaling과 reference accumulation 순서를 따라간다.
- 03
Coarse/fine error 입력과 progress·dwell reward의 역할을 각각 찾는다.
- 04
마지막 단계가 ‘정확한 관절 상태 직접 출력’이 아닌 PD 추종이라는 점을 확인한다.
한국어 해설은 이해를 돕기 위한 편집 해석이며 저자 논문에서 검증된 수치나 그림의 모든 패널을 대체하지 않습니다.
핵심 설계·학습 신호 해설
Reference-state Markov성
상태에 현재 measured q만 포함하면 같은 q이더라도 서보 reference z가 다른 두 사례를 식별할 수 없다. z−q 정보를 관측하는 이유는 PD가 관절을 ‘유지’하기 위해 남겨두는 오프셋을 정책에 노출하려는 것이다. Appendix simulation ablation에서는 feedback 제거 후 strict success가 9.2pp 떨어진다.
이중 오차 스케일과 gain은 상호 보완
fine channel은 0.5mm 및 0.25° 수준에서 오차를 읽게 하고, gain schedule은 작은 correction을 가능하게 한다. 하나는 상태 표현의 정밀도, 하나는 행동 해상도의 정밀도다. fine 제거는 median position 0.25→0.36mm, fixed gain은 entry time 1.73→2.28s로 바뀌었다(§5.1.2).
Dwell 보상이 왜 별도 필요한가
이전 최소 오차보다 좋아지는 progress reward는 허용 범위 안에 ‘그냥 있는’ 행동에 보상하지 않는다. dwell reward는 strict range 내부의 매 step에 지급해 도착 후 튀어나오는 정책을 줄인다. goal에 닿자마자 종료시키지 않는 학습 설정이 핵심이다.
Hardware 학습의 비용을 줄이는 방법
실제 10Hz 로봇에서 매 전이가 소중해 near-goal 재샘플링·HER goal relabel·단계적으로 시작 간격을 키우는 curriculum과 큰 회전 목표를 섞는다. Latent-alignment critic은 멀리 돌아가야 목표 자세로 들어갈 수 있는 경우 직선적 오차 감소의 유혹을 줄이려는 구성이다.
success의 3가지 정의
Sim Table 1은 160 step 후 마지막 30 step(1초) 평균의 1mm/0.2° 조건이다. Containment는 마지막 1초 모든 샘플, hardware Table 3의 held는 최종 5초 연속 만족이다. VLA Table 2는 조작 태스크 완료. 서로 변환할 수 없다.
실험과 주요 발견
Isaac Sim 4,120개의 train-disjoint 시작/목표 쌍에서 5.3초(160step) 단일 attempt 최종 1초 평균 position≤1mm, orientation≤0.2° 조건의 strict success는 PolicyIK 93.49±0.20%(3 training seeds), tuned DLS 50.41%, QP 56.21%, MPC 56.33%, UMI-RL 0%(Table 1). 실패 후 재시도하는 deployment protocol을 추가하면 98.92±0.23%이나 평균 1.212 attempts이므로 단일 모델 98.9% 1회 성공으로 표현하면 안 된다. 실제 7-DoF OpenArm에서는 60 pose task·25초 budget에서 PolicyIK 54/60 도달, 최종 5초 동안 1mm·0.2° 유지 43/60(71.7%), DLS 17/60·QP 16/60·MPC 15/60·OpenArm-QP 11/60(Table 3). Sim ablation은 command-state feedback 제거 −9.2 percentage points, fine channel과 gain 제거 각각 약 4–5 points이며, dwell 제거 시 허용 범위에 들어온 뒤 7.8%가 최종 1초 내내 머무르지 못해 기본 2.4%보다 높다. π0.5 LIBERO-Object 10과제 시뮬레이션 연계에선 95.7% success, hand-tuned DLS는 96.7%, default DLS/QP는 각각 90.8%(Table 2).
Figure 1 — 도달과 목표 내부 유지가 다르다는 시각적 증거
Figure 1(a)는 workspace full-pose 접근, (b)는 시뮬레이션 1mm·0.2° 정밀 도달·유지, (c)는 실제 OpenArm의 최종 5초 지속을 보여준다. 수치 검증은 Table 1(시뮬레이션)과 Table 3(실물)을 분리해야 한다.
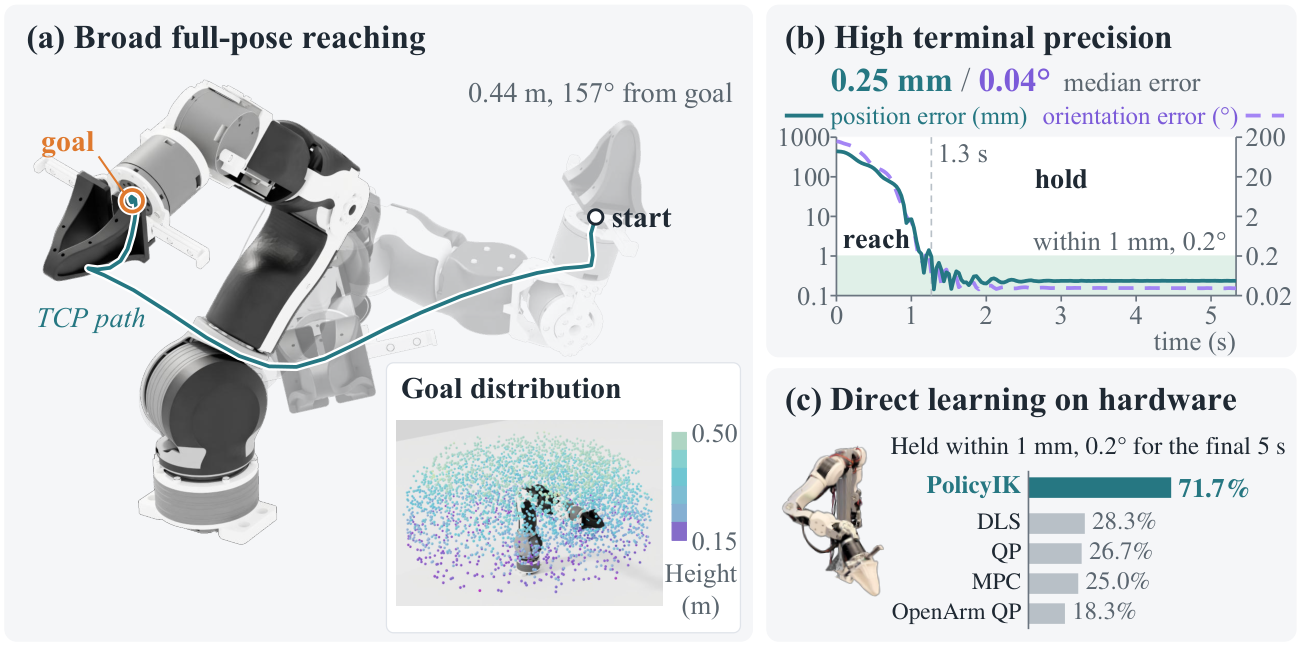
원문 캡션 일부 Figure 1: PolicyIK: from broad reaching to precise regulation. (a) Full-pose reaching across the simulated workspace. (b) Reaching and holding within 1…
- 01
(a)의 broad reaching을 최종 1mm success와 혼동하지 않는다.
- 02
(b)는 simulator 최종 1초 평균 strict success/containment와 연결한다.
- 03
(c)의 실물 데이터는 60 tasks·25s budget의 43/60 held와 연결한다.
- 04
실물 pose 오차는 joint encoder와 FK로 계산하며 외부 절대 측정이 아님을 명시한다.
한국어 해설은 이해를 돕기 위한 편집 해석이며 저자 논문에서 검증된 수치나 그림의 모든 패널을 대체하지 않습니다.
실험 결과를 제대로 읽기
| 평가 항목 | 보고된 결과 | 해석 / 실험 조건 |
|---|---|---|
| Sim held-out strict · Table 1 | 93.49±0.20% (single) | Isaac Sim 4,120 start–goal pairs, 160step 5.3s, 마지막 1초 평균 오차, 3 training seeds |
| Sim retry 포함 · Table 1 | 98.92±0.23%, E[N]=1.212 | 실패에 correction / transient goal retry; 1회 성공률로 둔갑시키면 안 됨 |
| 시뮬레이션 classic controller | DLS 50.41 / QP 56.21 / MPC 56.33% | Table 1 tuned controller, 별도 튜닝 세트, 동일 4,120 target |
| Sim median pose error | 0.25mm / 0.04° | Table 1 모든 task 포함 median terminal window errors |
| 실물 OpenArm 도달·유지 | 54/60 reached, 43/60 held | Table 3. 25s budget, 최종 5s 모든 샘플 1mm·0.2° |
| 실물 DLS 유지 | 17/60 held | Table 3, 같은 60 목표·25s; QP 16/60, MPC 15/60, OpenArm QP 11/60 |
| Feedback ablation | −9.2pp strict success | Figure 3/Table 7; reference-feedback 제거 |
| Dwell ablation | 7.8% vs 기본 2.4% 유지 실패 | 허용 범위에 진입한 task 중 마지막 1초 통째로 유지 못한 비율 |
| π0.5 IK 교체 실험 | PolicyIK 95.7%, tuned DLS 96.7% | Table 2, Isaac Sim LIBERO-Object 10 tasks×50 init×3 runs, strict IK 성공률 아님 |
ⓘ Position/orientation threshold를 만족하는 성공 기준은 평가 플랫폼마다 다르다. 실물 pose 오차는 joint encoder와 모델 forward kinematics로 산출하므로 외부 기준기 없이 절대 위치 정확도를 보장한다는 뜻이 아니다.
한계와 비판적 검토
가장 큰 구별은 시뮬레이터 IK의 pose 정확도와 물리 세계에서 독립 외부 센서로 측정한 pose 정확도가 같지 않다는 점이다. 실물 OpenArm의 오차는 joint encoder와 FK 기반 모델 gripper frame에서 계산하며 외부 metrology를 통한 절대 1mm 보증은 아니다(§5.2). 실물 학습은 FlashSAC 기반이라 시뮬레이션 PPO에서 그대로 sim-to-real 이전된 성과로 설명할 수 없다. 단일 arm 형상·defined workspace·충돌 없는 목표 샘플이라는 제한이 있고, VLA pick-and-place 95.7%는 Isaac Sim에서 task-specific 데이터 없이 얻었지만 tuned DLS 96.7%보다 낮다. Strict success는 마지막 1초 평균 에러 조건이며 모든 시점이 오차 이내여야 하는 containment, 실물 최종 5초 유지와 정의가 다르다. 시뮬레이션 classic baseline은 제어·중력 보상 조건 차이가 있고 시스템 안전성 검증은 별도다.
내 연구에 적용한다면?
아래는 논문 저자의 검증 결과가 아니라, 논문에서 출발해 설계한 **후속 실험 제안**입니다.
joint reference 기억(z−q)과 fine pose feedback·dwell 보상을 함께 넣으면 joint-limit 인접 목표에서 도달뿐 아니라 안정 유지 성공이 높아진다.
동일한 7-DoF arm·PD gains·FK 모델로 PolicyIK 및 DLS/QP/MPC를 평가하고 4,120 holdout 목표를 3 seed 이상 재현한다. Full, no-reference, no-fine, fixed-gain, no-dwell 네 ablation; 실물 60 target은 calibrated external motion-capture로 재측정한다.
separately tuned DLS, QP, MPC, UMI-RL, no-reference-feedback, fixed-gain, no-dwell; π0.5 pick-and-place에는 tuned DLS 포함
single-attempt strict, retry E[N], final-window containment, external 3D pose mm/deg error, hold 1/5s, robot safety stops, policy latency
1mm 수준 FK는 calibration bias에 취약하고 joint limit 및 충돌 안전조건이 중요하다. 하드웨어 RL 탐색은 torque/velocity emergency stop 등 보호 아래에서만 수행해야 한다.
원문을 읽으면서 확인할 4가지
- Figure 2의 정책 action과 PD reference 추종을 구분하고 command-state feedback의 위치를 표시한다.
- Eq.(5)의 coarse(1cm/20°)·fine(0.5mm/0.25°) 수치와 Eq.(6) gain 식을 따라간다.
- §3 마지막 1초 평균 criterion과 containment, 실물 마지막 5초 연속 criterion을 따로 적는다.
- Table 1의 93.49%와 deployment 98.92% 아래 E[N] 1.212를 확인한다.
- Figure 1(c)의 실물 holding 묘사가 Table 3의 43/60과 어떤 관계인지 확인한다.
- §5.1.3의 95.7% 옆 tuned DLS 96.7%를 반드시 함께 표시한다.
읽고 나서 남는 질문
- Figure 2의 누적 command reference z−q를 제거했을 때 왜 ‘가끔 도착’보다 ‘최종 유지’가 더 나빠지는가?
- coarse/fine 센서 스케일이 1mm 아래에서 perception noise를 과증폭하지 않는가?
- Table 1의 93.49% 단일 시도와 98.92% deployment retry를 같은 success로 보고할 수 있는가?
- 실물 Table 3의 FK 기반 오차와 외부 optical tracker의 pose error 차이는?
- π0.5 연계 시 hand-tuned DLS 96.7%가 PolicyIK 95.7%를 소폭 앞서는 조건은 무엇인가?
원문 / 출처 확인
편집자가 작성한 초록 기반 한국어 요약이며 공식 영문 초록의 원문/번역이 아닙니다.
일반적인 역기구학 해법의 목표는 관절을 목표 pose 근처로 데려오는 것이지만, 실제 로봇은 도착 후 1mm·0.2도 오차 안에서 머물러야 한다. PolicyIK는 goal-conditioned RL로 관절 참조 상태·미세 포즈 오차·유지 보상을 함께 최적화하며, 시뮬레이션과 별도 실물 학습 및 VLA 연계 실험을 구분해서 검증한다.
해설은 논문 저자들의 진술과 편집자의 비판적 질문을 구분합니다. 특정 지표·인과관계·재현성을 판단할 때는 반드시 원문의 실험 설정을 확인해 주세요.